跳到主要内容
博客 · 文档自动化

使用 Power Automate 进行高级图像 OCR

2022年5月29日 · 使用Power Automate的PDF OCR功能识别扫描文档和图像中的文本。此外,还可以使用正则表达式重命名文件以进行排序。

我们拍摄大量包含文字的文档或表面图像,用于提取数据或供后续参考。将扫描的文档或图像转换为可搜索的PDF文件对于后续处理至关重要。实现PDF可搜索性最常用的技术是光学字符识别(OCR)。

PDF4me 提供高质量的 PDF OCR 功能,能够实现极高的文本识别准确率。但是,当您需要识别数百份扫描文档时,唯一的解决方案就是自动化。PDF4me 也提供了相应的解决方案。

PDF4me 与 Microsoft Power Apps 中的 Power Automate 结合使用,可以自动执行繁琐耗时的文档处理业务流程。PDF4me 与 Power Automate 联动,可连接各种数据源、应用和服务,轻松创建强大的工作流,实现文档处理的自动化。

如何在 Power Automate 中使用 OCR?

让我们来看一个例子,了解如何使用 Power Automate 中的 PDF4me OCR 功能将图像转换为 PDF。假设我们在 OneDrive 中有一些文档图像或包含文本的图像,或者我们预期它们会出现在特定文件夹中。让我们将它们转换为 PDF 并进行 OCR 识别。
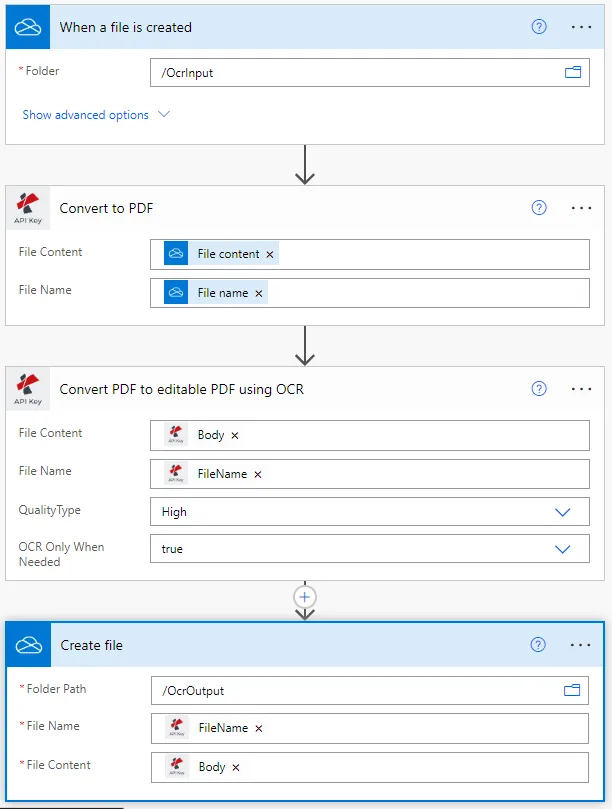
使用 Power Automate 的高级 PDF OCR 流程

添加 OneDrive 触发器

Power Automate 提供多种触发器来启动您的工作流程。在本用例中,添加一个 OneDrive 触发器来启动自动化流程。
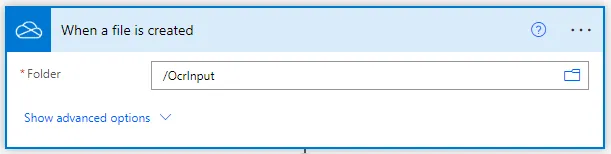
Google Drive 触发器用于 OCR 流程

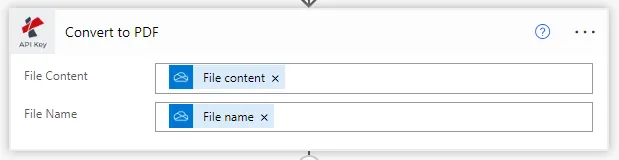
添加“转换为 PDF”功能,用于文档图像

完成触发步骤后,点击“新步骤”。此时会弹出一个包含多个应用推荐的提示,您需要搜索 PDF4me 并选择PDF4me Connect 。从操作列表中选择“转换为 PDF”操作

将图像转换为 PDF 的操作

选择“使用 OCR 将 PDF 转换为可编辑格式”操作

从 PDF4me 操作列表中选择 PDF OCR

文件内容:映射源 PDF 文件内容(来自上一步操作)文件名:映射源 PDF 文件内容(来自上一步操作)质量类型:选择质量类型。草稿或高

PDF4me 建议使用高质量配置文件 OCR 处理图像,以确保即使是复杂的图像也能准确识别。
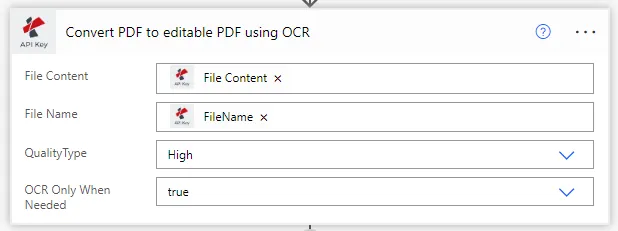
PDF4me 的 PDF OCR 操作

保存 OCR 处理后的文件

最后,在 OCR 操作之后,添加一个操作,将输出的 PDF 文件保存到所需的存储位置。在本例中,我们再次使用 OneDrive 保存操作。
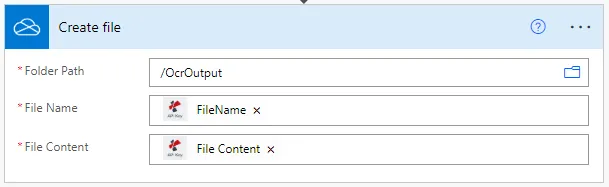
将 OCR 处理后的 PDF 文件保存到 OneDrive

您还可以在“文件名”字段中使用正则表达式(RegEx)来创建动态名称,以便更好地对已处理的文档进行排序。
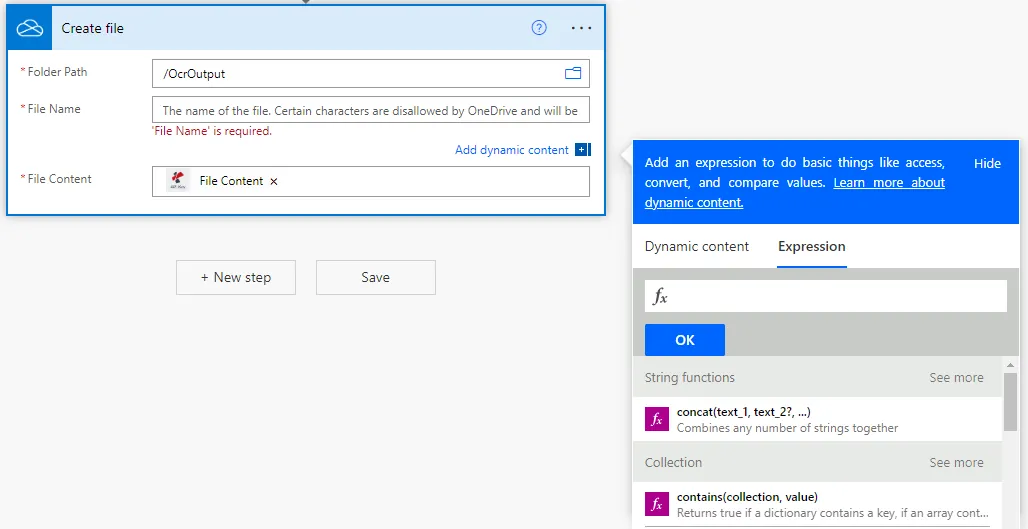
在 Power Automate 中使用正则表达式动态命名文件名

可用于 OCR 的即用模板

为了帮助您快速上手,我们准备了一些模板供您使用。

把你的文件准备好。

您可以使用 API 将其集成到您的产品中,无需编写代码即可实现自动化,或者使用浏览器中的免费工具。无需信用卡即可开始。

从一次通话开始curl -X POST https://api.pdf4me.com/v1/ConvertToPdf

免费版 · 无需信用卡