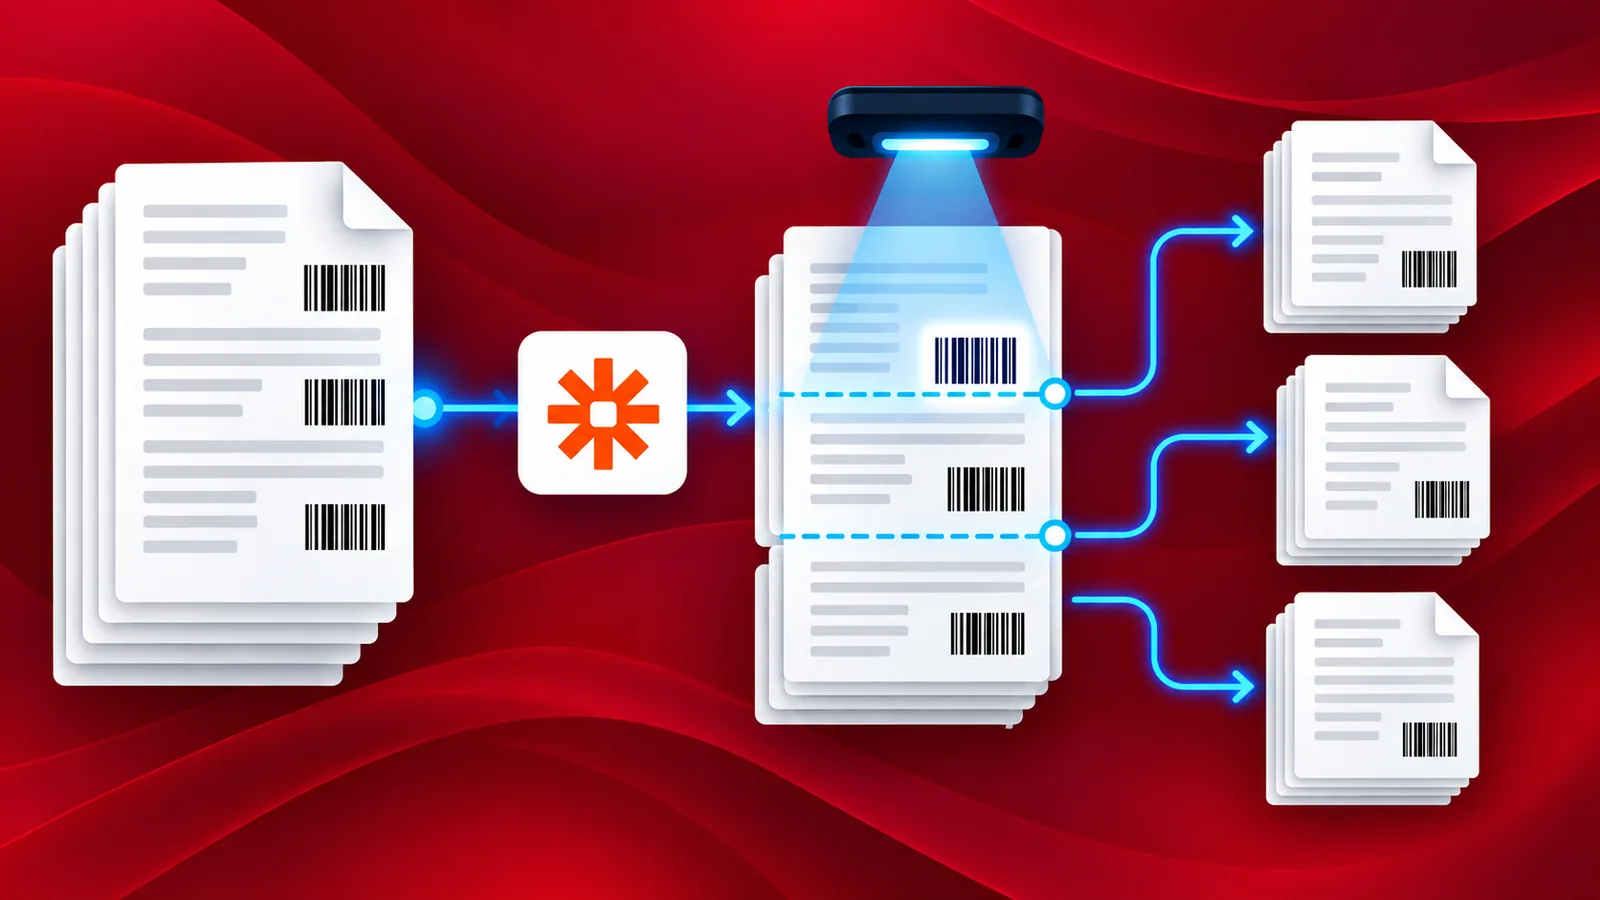
按条形码拆分 这是一个适用于 Zapier 的 PDF4me 操作,它会将一批扫描文件分割成多个 PDF 文件,分割点为条形码所在位置。该 Zap 包含六个步骤:监控 Dropbox,筛选 PDF 文件,根据二维码分割文件,循环处理分割后的文档,并将每个文档保存为单独的名称和日志信息。
一次性扫描二十张发票,即可得到一个八十页的 PDF 文件。按页码分割只有在每张发票长度相同的情况下才有效,而实际情况并非如此。条形码分隔符可以解决这个问题:无论页数多少,分割点都位于条形码所在位置。这些截图来自 2026 年 11 月 3 日运行的 Zap 程序。
在每份文档前面放置一张带有二维码的分隔页,将整叠文档扫描成一个 PDF 文件,然后上传到 Dropbox。PDF4me 会根据每个条形码分割文档,Zapier 的循环功能会遍历分割后的列表,并将每个文档单独保存为 AP-Batch-Scan-Nov-01_1.pdf、_2.pdf 等,每个文档都会在日志文件中记录一行。
基于“为什么”的问答
为什么按条形码而不是页数分割? 页数不一。有的发票是两页,有的则是五页。条形码分隔符清晰地标示出页码边界,因此无论页数多少,分割都准确无误。这是唯一一种能够处理不同批次发票的方法。
为什么需要循环呢? 按条形码拆分会返回一个文档列表,而不是单个文件。如果没有循环,Zap 只会处理第一个项目。Zapier 的循环功能会将该列表转换为每个文档一次遍历,因此步骤 5 会运行与条形码数量相同的次数。
为什么分页显示“条形码之前”? 分隔符页属于其后的文档,而不是其前的文档。在条形码之前拆分文件,每个新文件都会以各自的分隔符开始。选择“之后”拆分,则会将每个分隔符都附加到前一个文档。
为什么 PDF 渲染分辨率要设为 150 DPI? 该操作通过栅格化页面来查找条形码。栅格化程度过低会导致密集条形码无法读取,栅格化程度过高则会导致批量处理速度过慢。栅格化程度为 150 时,无需进行长达八十页的扫描,即可可靠地读取标准二维码分隔符。
您将获得
输入: 一个扫描的 PDF 文件,其中包含多个文档,每个文档前面都有一个带有二维码的页面。 输出: /SplitBarcodeAP/Output 中每个文档生成一个 PDF 文件,编号从批次名称开始;/SplitBarcodeAP/Log/split-barcode-log.txt 中每个文档生成一行。
你需要什么
- Zapier。 打开 PDF4me Zapier 应用共六个步骤,外加循环功能,因此需要付费的 Zapier 计划。
- PDF4me API密钥。 获取您的 API 密钥首次添加 PDF4me 操作时进行连接。
- Dropbox 使用 /SplitBarcodeAP/Input、/SplitBarcodeAP/Output 和 /SplitBarcodeAP/Log。
- 分隔页 携带一个二维码,其文本以已知字符串开头。此版本使用
PDF4me 条形码。
先拿到样品。 输入是一个包含两个文档的批次,文档之间用二维码隔开。输出是 Zap 根据该批次生成的两个结果。
流程概览
- 文件夹中的新文件 (Dropbox 触发器,每 2 分钟进行一次投票)。
- 过滤条件 (通过 Zapier 筛选)仅适用于 PDF 文件。
- 按条形码拆分 (PDF4me) 在每个二维码处切断批次。
- 从行项目创建循环 (通过 Zapier 循环)迭代结果。
- 上传文件 (Dropbox) 会保存每个文档。
- 创建或追加到文本文件 (Dropbox) 会记录每个文档。
完整流程概述
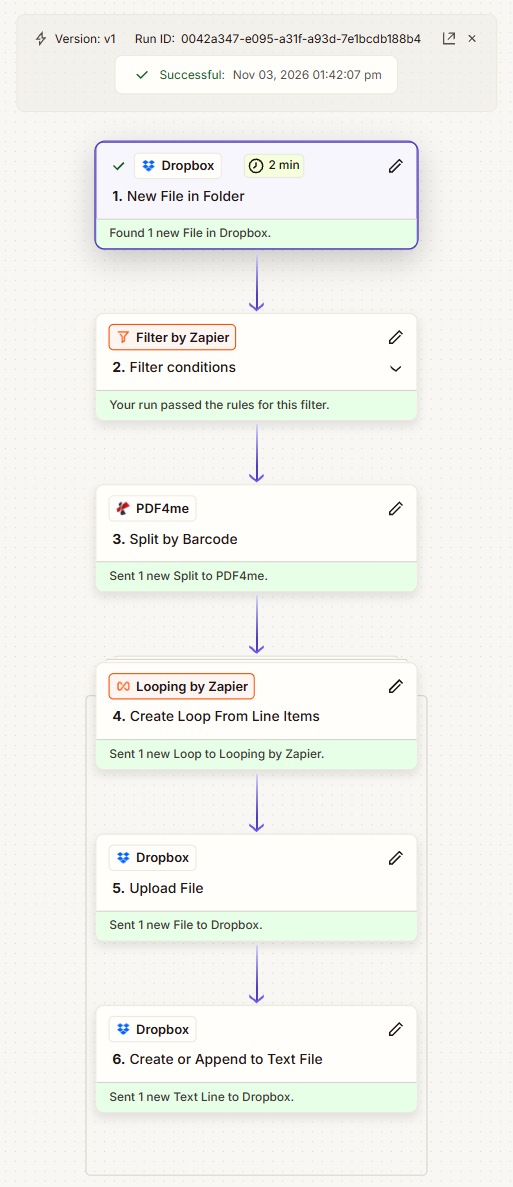
2026 年 11 月 3 日运行成功。步骤 5 和 6 位于循环内,因此每个拆分文档都会重复执行一次。
步骤 1:如何监视 Dropbox 文件夹中的扫描批次?
目前为止的流程: 目前还没有什么,这是触发点。
- 添加 Dropbox 作为触发应用程序并选择 文件夹中的新文件 事件。
- 配置:
- 空间:
Default - 文件夹:
/SplitBarcodeAP/Input - 是否包含子文件夹中的文件?:
False - 是否包含文件内容?:
Yes - 包含分享链接吗?:
No
- 空间:
文件夹配置中的新文件
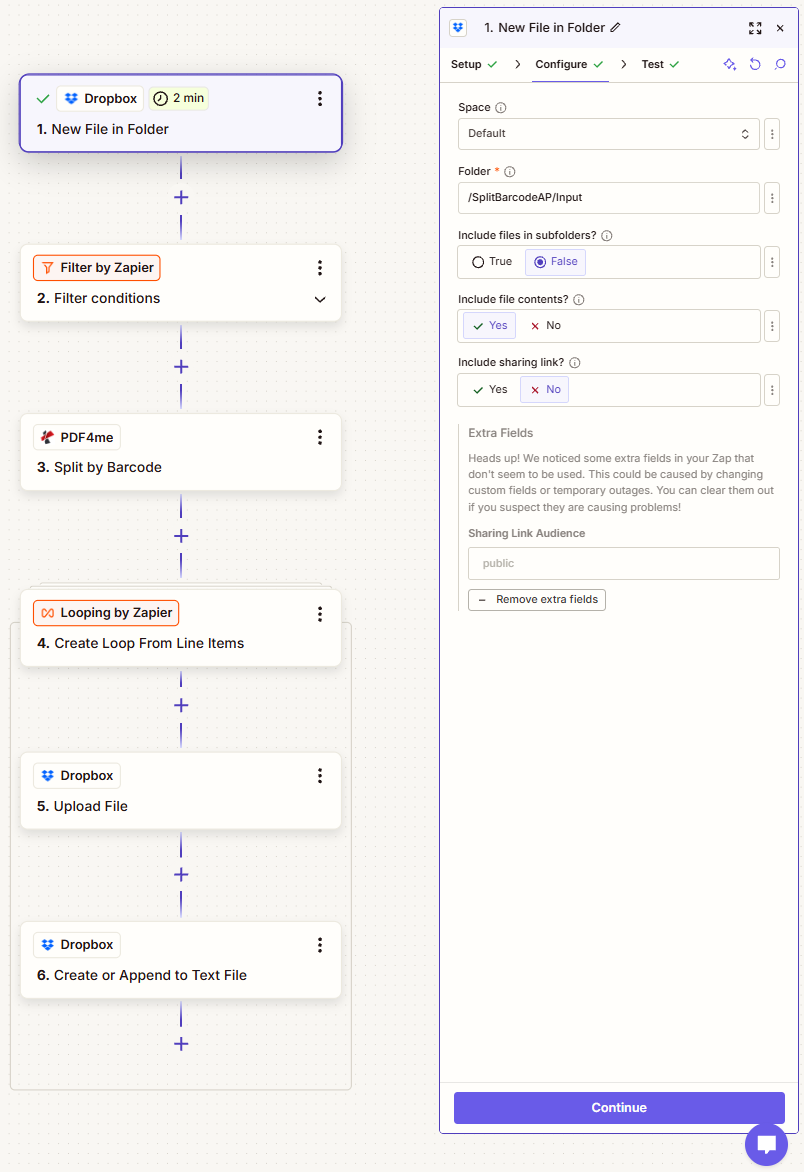
扫描仪通常会先写入一个临时文件。如果你的扫描仪也有这个功能,请将触发信号指向扫描仪将扫描完成后的文件移动到的文件夹,而不是它写入文件的文件夹。
步骤 2:为什么要先过滤再拆分?
目前为止的流程: 文件夹中新建文件。
- 添加 通过 Zapier 筛选 并开放 过滤条件。
- 放 仅当: 1. 文件扩展名
(Text) Containspdf。
过滤器条件配置
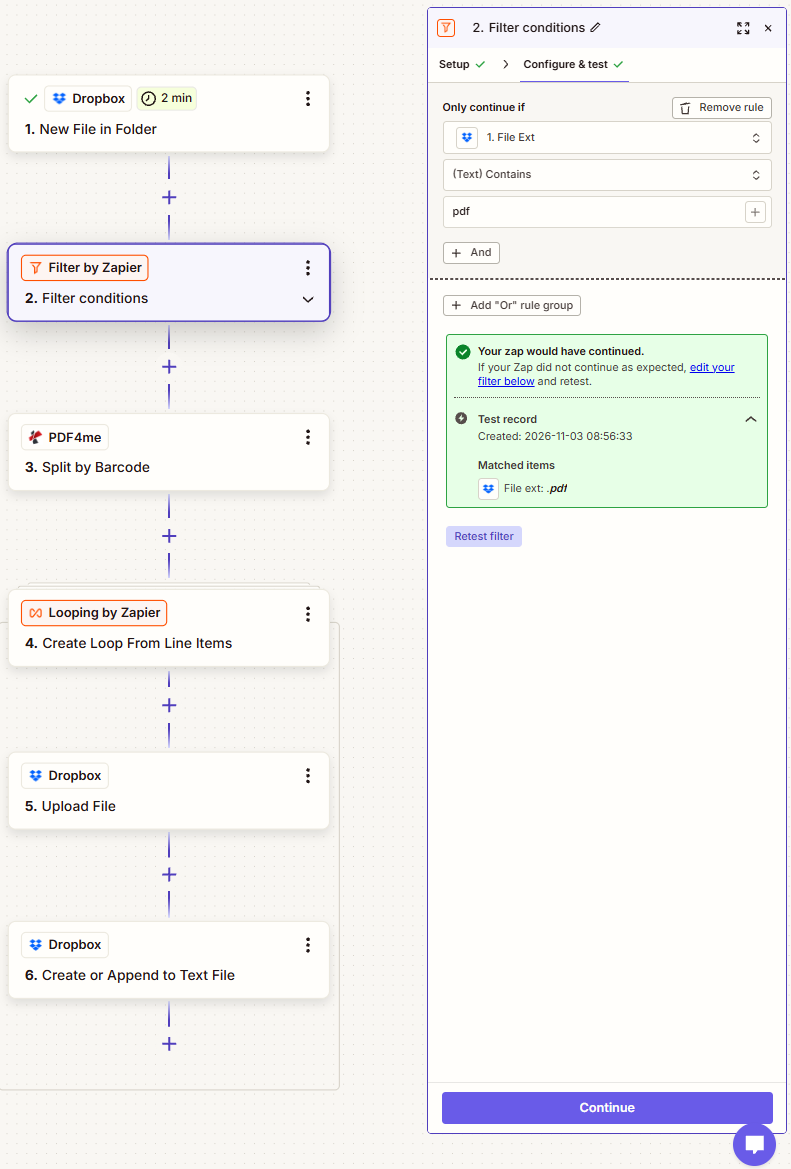
拆分是此 Zap 中最耗费资源的步骤,因此,与在更轻量级的工作流程中相比,对其进行限制更为重要。 Zapier 的过滤器指南 为了更严格的规则。
步骤 3:按条形码分割如何决定在哪里切割?
目前为止的流程: 在文件夹中新建文件并添加筛选条件。
四个必填字段控制拆分。条形码文本和筛选条件决定哪些条形码有效,拆分页面决定拆分点位于分隔线的哪一侧。
- 添加 PDF4me 并选择 按条形码拆分 行动。
- 配置:
- 文件: 这 文件 步骤 1 的输出
- 指定文件名: 这 文件名 从步骤 1 开始,这里
AP-Batch-Scan-Nov-01 - 条形码文本:
PDF4me Barcode - 条形码筛选:
Starts with - 条形码类型:
Only QR Code - 分割条形码页:
Before the barcode - PDF渲染DPI:
150 - 合并具有相同条形码的页面:
False - 返回 Zip:
False
按条形码参数拆分
| 场地 | 所用价值 | 它控制着什么 |
|---|---|---|
| 文件 | 步骤 1 中的文件 | 已扫描批次。请提供文件或文件 URL。 |
| 指定文件名 | AP-Batch-Scan-Nov-01 | 拆分后的文档编号均以此为基础名称。 |
| 条形码文本 | PDF4me Barcode | 分隔符条形码所承载的文本。 |
| 条形码筛选 | Starts with | 条形码文本匹配方式。(必填) |
| 条形码类型 | Only QR Code | 仅允许检测一种符号体系。必填。 |
| 分割条形码页 | Before the barcode | 切口落在分隔器的哪一侧?(必填) |
| PDF渲染DPI | 150 | 用于读取码片的栅格化质量。必填。 |
| 合并具有相同条形码的页面 | False | True 会将所有具有相同条形码值的部分合并到一个文件中。 |
| 返回 Zip | False | False 返回文档列表,这正是循环所需要的。 |
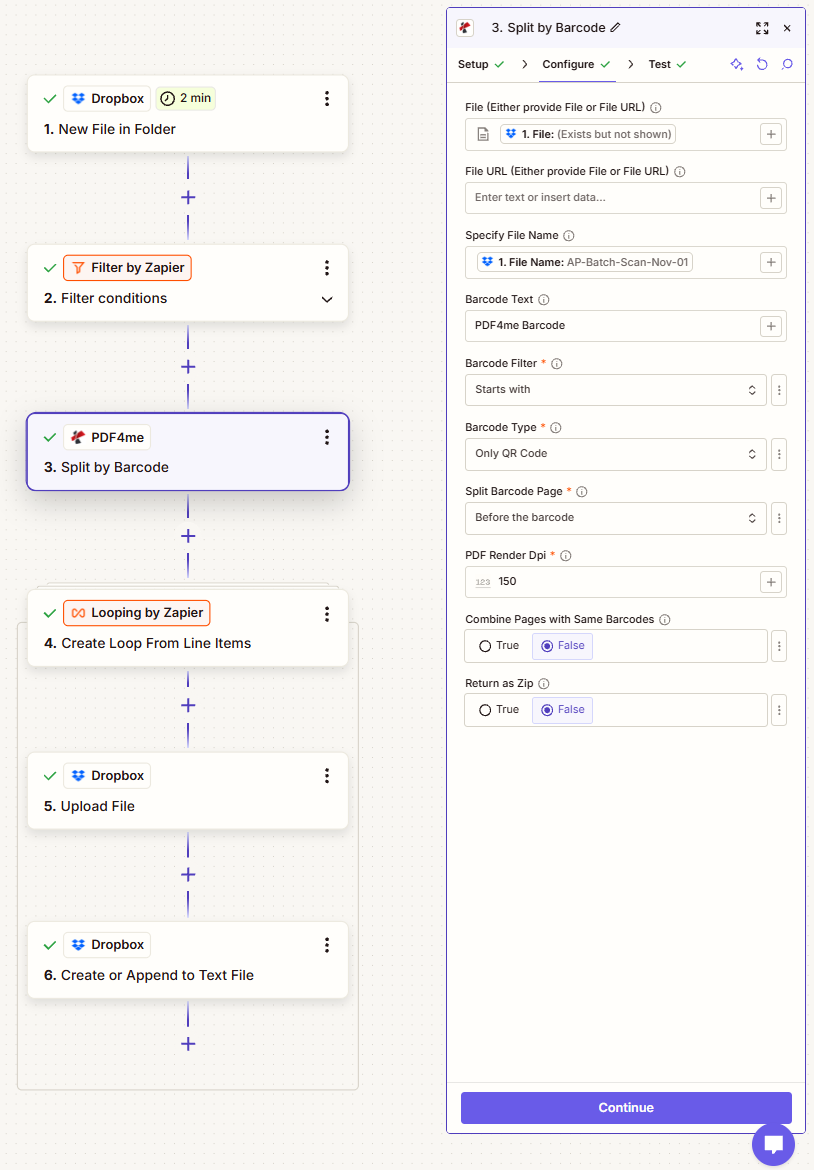
“返回 Zip”选项故意保持为 False。因为 zip 文件是一个单独的文件,而步骤 4 中的循环需要的是各个单独的文档。
提示。 条形码类型在此处设置为“仅限二维码”,这样可以加快检测速度,并避免将发票上的零星 Code 128 条形码误认为是分隔符。仅当您的分隔符确实使用多种条形码时才应加宽此设置。
步骤 4:如何处理拆分文档列表?
目前为止的流程: 在文件夹中新建文件,并添加筛选条件和按条形码拆分。
步骤 3 会返回多个文档。循环会将该列表转换为对每个文档执行一次迭代,并且之后的所有操作都会对每个文档执行一次。
- 添加 Zapier 循环 并挑选 从行项目创建循环。
- 在下面 要循环的值,将两组值相加:
url映射到 3. 文档文件 URLname映射到 3. 文档文件名
- 配置:
- 修剪空白:
True - 循环迭代计数器开始:
1 - 循环迭代的最大次数:
500
- 修剪空白:
从行项目配置创建循环
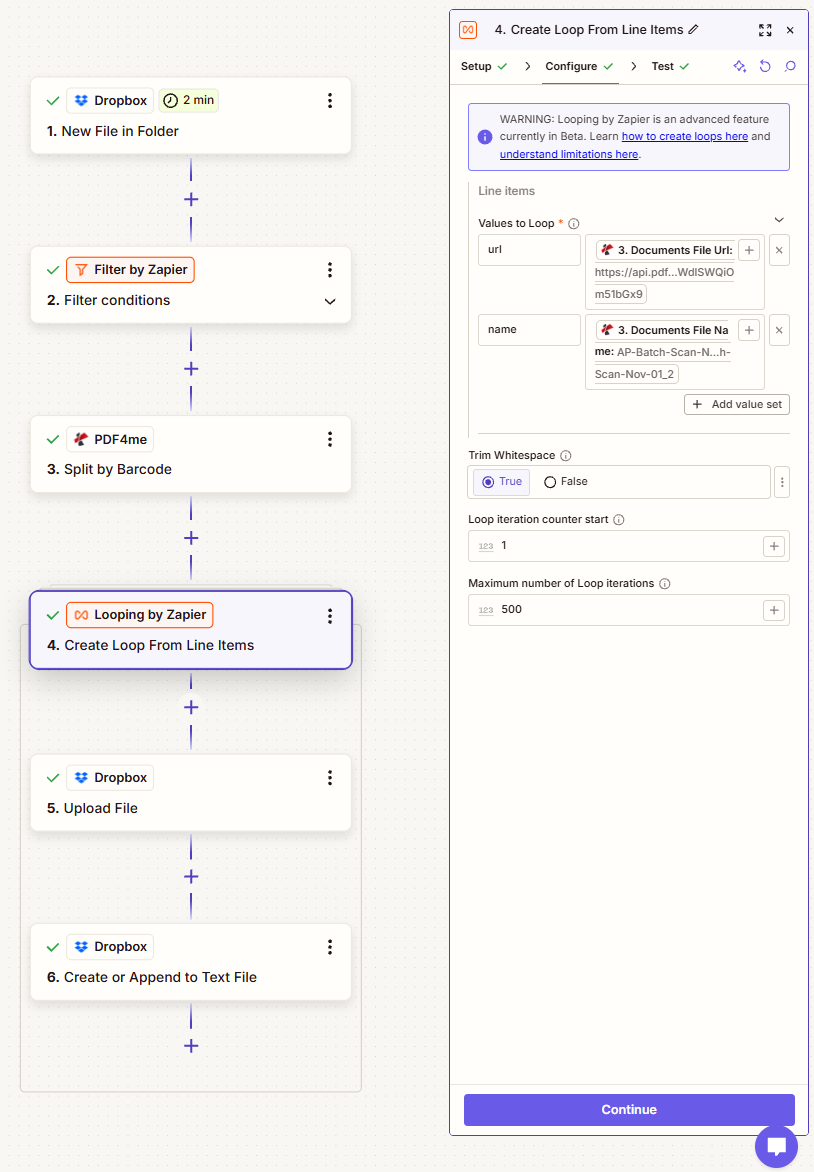
这两个值集都很重要。URL 是要上传的内容,文件名是文件的名称,它们保持一致是因为它们来自同一个订单项。
步骤 5:每个拆分后的文档应该放在哪里?
目前为止的流程: 在文件夹中新建文件 + 筛选条件 + 按条形码拆分 + 从行项目创建循环。
这一步和下一步都在循环内,因此每个文档只运行一次。
- 添加 Dropbox 并选择 上传文件 行动。
- 配置:
- 空间:保持未设置状态
- 文件夹:
/SplitBarcodeAP/Output - 文件: 这 网址 从循环中获取值,步骤 4
- 覆盖:
True - 指定文件名: 这 姓名 循环中的值,这里
AP-Batch-Scan-Nov-01_1 - 指定文件扩展名:
pdf - 包含分享链接吗?:
Yes
上传文件配置
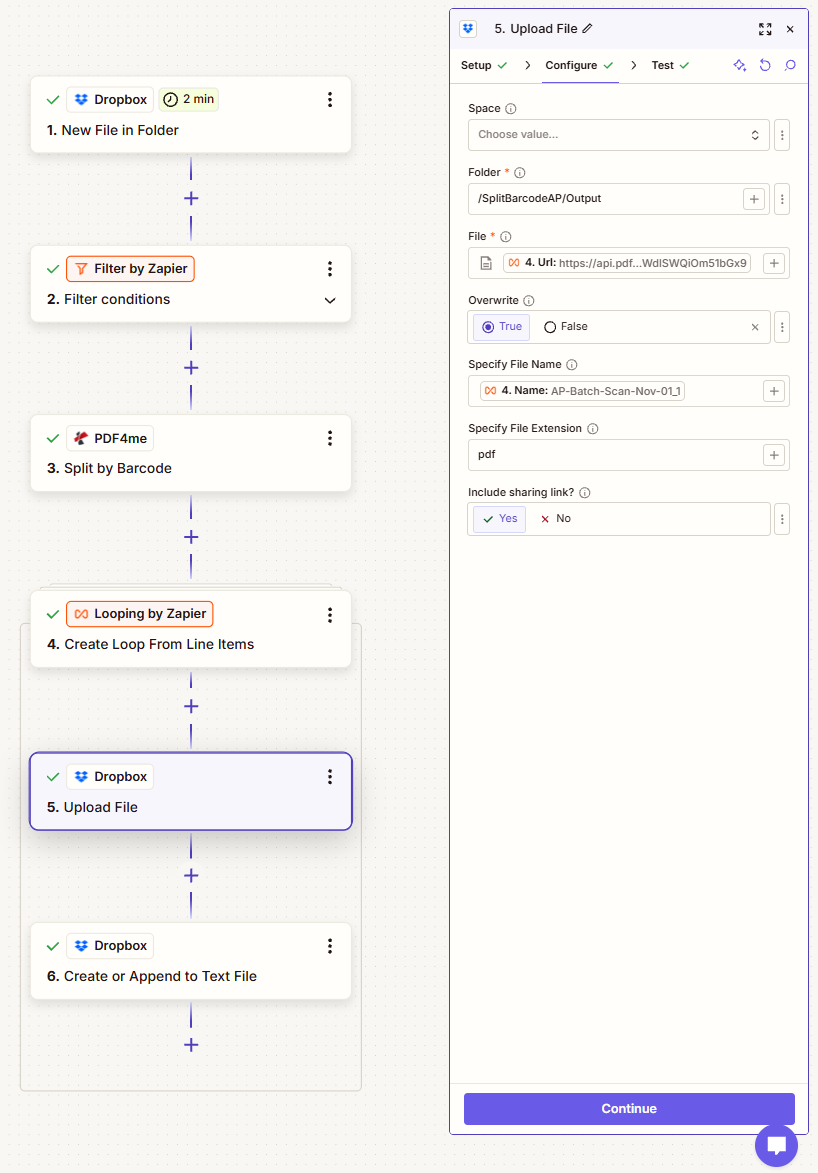
“文件”和“指定文件名”这两个参数都来自循环,而不是直接来自步骤 3。这样才能确保文档 2 的字节与其名称配对。
步骤 6:如何记录生成的每一份文件?
目前为止的流程: 前五个步骤全部重复,其中第 5 步和第 6 步在每个文档中重复。
- 添加 Dropbox 并选择 创建或追加到文本文件 行动。
- 配置:
- 空间:保持未设置状态
- 文件夹:
/SplitBarcodeAP/Log - 文件名:
split-barcode-log.txt - 文件内容:字面文本
Split OK:然后是 姓名 循环中的值 - 包含分享链接吗?:
Yes
创建或追加到文本文件配置
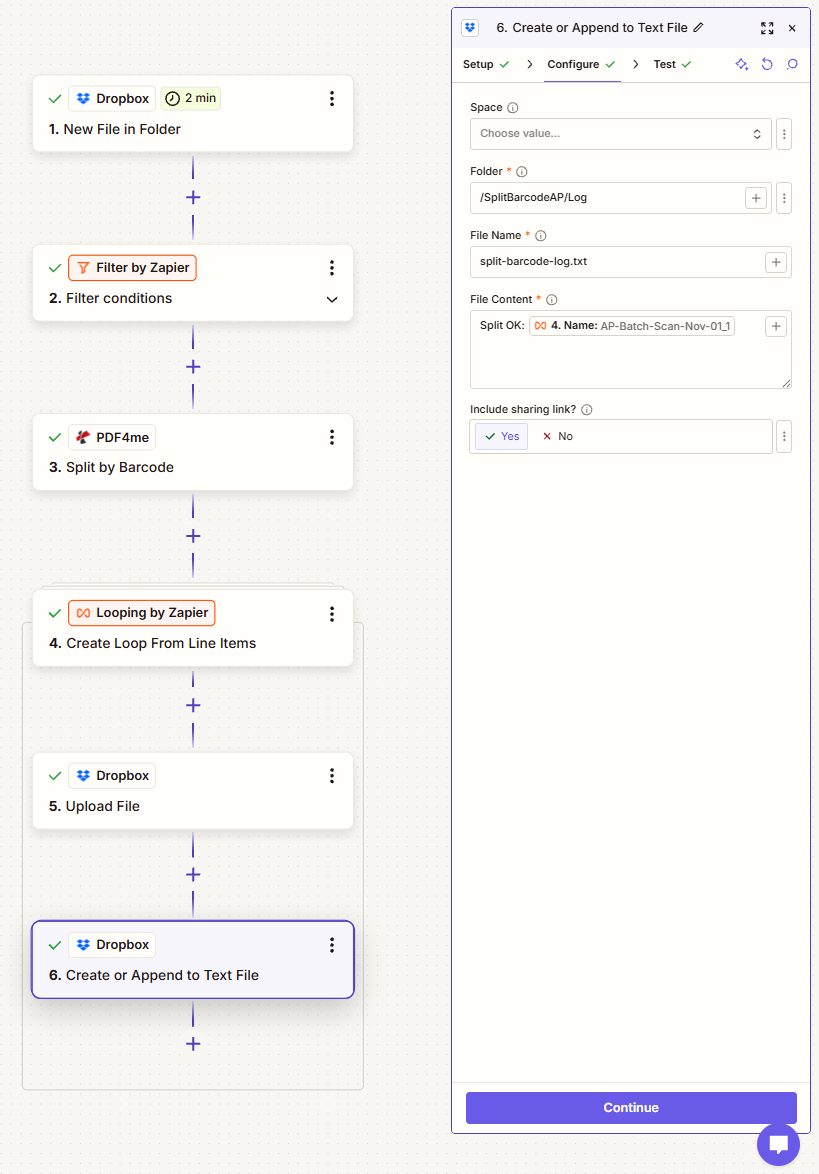
因为这是在循环内运行的,所以一批十二个文档会生成十二行日志,这是确认拆分计数是否正确的最快方法。
运行流程并验证
- 发布 电击。
- 在每个文档前面放一个分隔页,将一叠文档扫描成一个 PDF 文件,然后将其放入 /SplitBarcodeAP/Input 中。
- 打开 Zap 运行 检查循环报告,确保迭代次数与分隔符的数量相同。
- 打开 /SplitBarcodeAP/Output 目录,确认每个文档对应一个文件,编号为 _1、_2 等,然后检查 split-barcode-log.txt 文件是否有匹配的行。
你实际建造了什么? 邮件收发室。一次扫描即可取代分拣,分隔页上印有操作说明,无需人工记忆。只需将同一形状的条形码对准采购订单、送货单或已签署的合同,即可看到不同的条形码文本。
无需重建即可添加的常见变体
条形码分割与页码分割
| 方法与方法 | 按条形码拆分 | 按页码分割 |
|---|---|---|
| 长度不一的文件 | 条形码经处理后,标记边界。 | 长度不同时立即中断 |
| 每批次设置 | 没有,分隔纸随纸张一起移动。 | 有人负责计算页码。 |
| 谁准备的 | 无论谁负责叠放纸张 | 之后打开PDF文件的人 |
| 规模可达一百份文件 | 是的,一次扫描。 | 不切实际 |
| 需要一个分隔页 | 是的 | 不 |
常见问题
如何将PDF文件分割成多个文件?
选择分割规则。通常的规则是页码,但此功能会将页码替换为条形码。PDF4me 的“按条形码分割”功能会扫描每一页,查找与您的条形码文本和条形码筛选条件匹配的条形码,并为每个部分返回一个单独的文档。
如何将PDF页面拆分成不同的文件?
如果您希望每一页都作为单独的文件,那么条形码分割就不合适了,直接使用“分割 PDF”操作会更简单。条形码分割适用于文件边界与页面边界不一致的情况,而这正是扫描的多页文档批次的典型特征。
哪些条形码类型可用于分割 PDF 文件?
“条形码类型”下拉菜单用于选择操作要查找的条形码类型。此版本使用 仅限二维码这样可以确保快速检测,并避免匹配发票上打印的无关条形码。如果您可以控制分隔页的类型,限制条形码类型通常是正确的选择。
不知道页码的情况下,我可以分割PDF文件吗?
这就是这种方法的关键所在。在 Zap 操作中,你无需指定页码。分隔页包含边界信息,因此,即使文档长度分别为两页、五页和九页,批次也能自动正确分割,无需人工计数。
故障排除
由于没有匹配的条形码,因此该批次产品从未被切割。请检查条形码文本是否与分隔符实际编码的内容一致,条形码筛选条件是否设置为“以……开头”而非“完全匹配”,以及条形码类型是否包含您的条形码体系。
PDF渲染分辨率过低,无法保证打印质量。请将分辨率从150提高一些,然后重新测试。另一个常见原因是分隔页倾斜或模糊,因此请重新打印分隔页,而不是大幅提高分辨率。
步骤 5 和 6 位于循环之外,或者说,如果 Zip 为 True,则返回结果为真,因此只有一个项目需要迭代。这两种方法都使 Zap 恢复到处理单个文件的状态。
条形码拆分页设置为“之后”而非“之前”。“之前”设置是指条形码位于每个新文档的起始位置,也就是使用分隔符,而分隔符的作用就在于此。
后续步骤
同样的六步模式(观察、门控、分割、循环、保存、记录)可以处理任何“一个文件输入,多个文件输出”的自动化。