我们经常会遇到大量文档,而我们只需要其中的一小部分信息。例如,合同、法律文件或电子书等PDF文档可能包含成百上千页。有时,我们可能只需要这些文档中的几页。在这种情况下,我们需要使用特定的工具来提取这些PDF页面。但所有软件服务都能够做到这一点。
现在,您可以使用PDF4me 的**“提取页面”**操作,自动从 PDF 文档中提取特定页面。使用PDF4me Connect集成中的Power Automate操作,即可创建用于自动化此过程的流程。只需简单的配置,无需任何编码,即可轻松设置用于提取 PDF 页面的流程。
如何自动从PDF中提取页面?
利用此功能,可以将文档页面分离出来并进行进一步处理。让我们通过一个示例流程来了解如何构建一个流程来自动提取 PDF 页面。
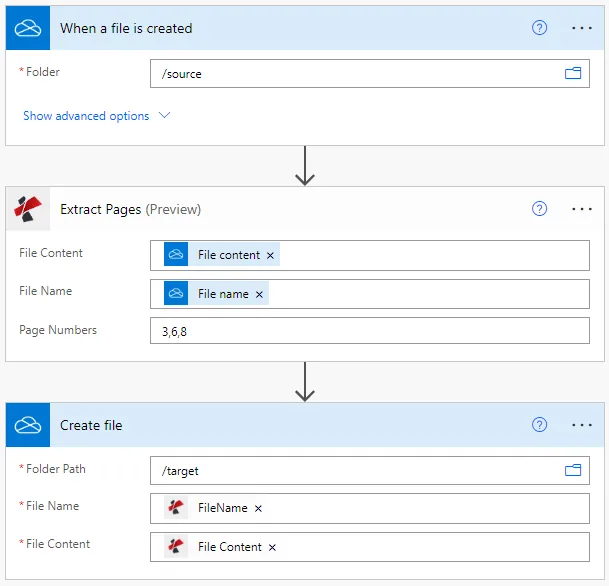
为流程添加触发器
您可以添加任何您选择的触发器,将输入的 PDF 文档传递给 PDF4me 的提取操作。在本例中,我们添加并配置一个 OneDrive 触发器。映射您预期 PDF 文件到达的文件夹。

添加“从 PDF 中提取页面”操作
添加并配置 PDF4me Connect 操作,以从 PDF 中提取页面。指定要从源 PDF 中提取的页面的页码。

添加保存输出的操作
既然我们已经从 OneDrive 存储开始,那么让我们添加 OneDrive创建文件操作,以保存使用从源文件中提取的页面创建的 PDF。
