从PDF中提取页面 这是一个适用于 Zapier 的 PDF4me 操作,它可以将 PDF 文件中的指定页面范围复制到一个新文件中。这个五步 Zap 操作会监视 Dropbox 文件夹,筛选 PDF 文件,提取您指定的页面,将结果保存为可追踪的文件名,并将一行信息追加到日志文件中。
从一份六十页的报告中提取三页只需十秒钟。但如果要对每一份收到的报告都这样做,那就没那么容易了。目前所有排名靠前的在线提取工具都假定是由人工操作,手动选择页码。本教程展示了该工具的自动运行版本,并附有截图和2026年11月2日运行的Zap的精确字段值。
将 PDF 文件拖放到受监控的 Dropbox 文件夹中。过滤器会过滤掉所有非 PDF 文件,PDF4me 会将第 1 页和第 2 页提取到一个新文档中,Dropbox 会将其保存为 Extracted-Quarterly-Report-Q3.pdf,日志文件中会新增一行记录,包括来源、范围和共享链接。只需五步,无需手动选择页面。
基于“为什么”的问答
既然文件夹里只有PDF文件,为什么还要添加过滤器? 文件夹很少能保持如此整洁。否则,一个遗漏的 .docx 文件、一个 .DS_Store 文件,或者一个只上传了一半的文件都会到达 PDF4me,导致运行失败。这个过滤器没有任何成本,却能将红色错误信息转化为干净利落的停止操作。
为什么输出文件夹与输入文件夹不同? 触发器会监视 /ExtractPages/Input/ 目录。如果提取的 PDF 文件被写回同一个文件夹,Dropbox 会报告一个新文件,Zap 会触发自身的输出,然后如此反复。
为什么要将日志记录到文本文件中? Zapier 中的 Zap 运行历史记录会过期。而添加到 extract-pages-log.txt 文件中的一行记录是永久性的,它与文档位于同一位置,并且任何拥有 Dropbox 访问权限的人都可以读取,而不仅仅是 Zap 的所有者。
为什么要给源文件的输出命名? Extracted-Quarterly-Report-Q3.pdf 会告诉你它的来源。而通用名称则不会,一旦文件夹里堆积了几百个这样的文件,可追溯的名称和不透明的名称之间的差别就可能长达几个小时。
您将获得
输入: 任何拖放到 /ExtractPages/Input/ 中的 PDF 文件。 输出: 在 /ExtractPages/Output 中生成一个新的 PDF 文件,其中只包含您指定的页面,并在 /ExtractPages/Log/extract-pages-log.txt 中添加一条审计记录。
你需要什么
- Zapier。 打开 PDF4me Zapier 应用这是一个五步 Zap,因此需要付费的 Zapier 计划。
- PDF4me API密钥。 获取您的 API 密钥首次添加 PDF4me 操作时进行连接。
- Dropbox 包含三个文件夹:/ExtractPages/Input/、/ExtractPages/Output 和 /ExtractPages/Log。
- 用于测试的多页 PDF 文件下面的示例就是这些屏幕截图中使用的示例。
先拿到样品。 Zap 发布后,将捆绑包放入 /ExtractPages/Input/ 目录,并将 /ExtractPages/Output 目录中的内容与预期输出进行比较。
流程概览
- 文件夹中的新文件 (Dropbox 触发器,每 2 分钟进行一次投票)。
- 过滤条件 (通过 Zapier 筛选)仅适用于 PDF 文件。
- 从PDF中提取页面 (PDF4me)带有页面范围。
- 上传文件 (Dropbox)保存提取内容。
- 创建或追加到文本文件 (Dropbox)写入审计行。
完整流程概述
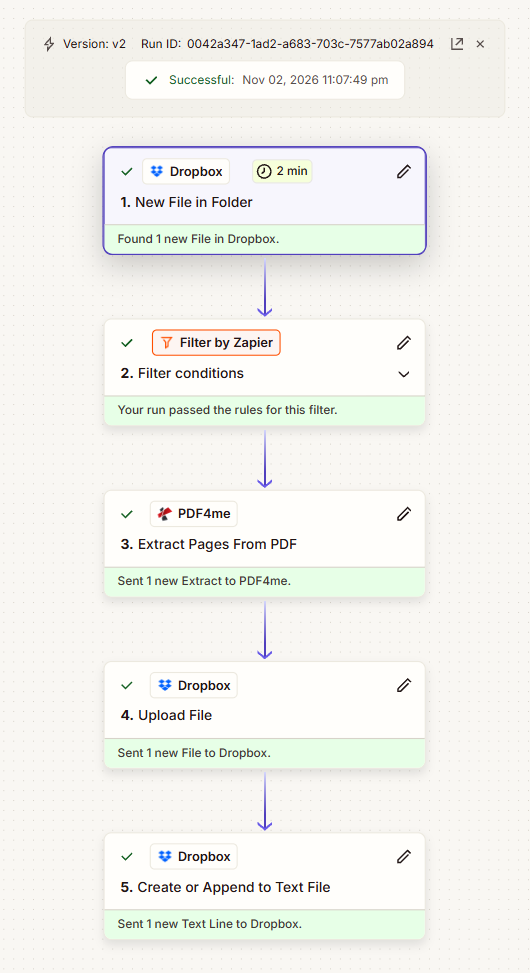
2026年11月2日运行成功。过滤器位于第二位,因此只有PDF文件才能到达PDF4me。
步骤 1:如何监视 Dropbox 文件夹中的新 PDF 文件?
目前为止的流程: 目前还没有什么,这是触发点。
- 添加 Dropbox 作为触发应用程序并选择 文件夹中的新文件 事件。
- 配置:
- 空间:
Default - 文件夹:
/ExtractPages/Input/ - 是否包含子文件夹中的文件?:
False - 是否包含文件内容?:
Yes - 包含分享链接吗?:
No
- 空间:
文件夹配置中的新文件
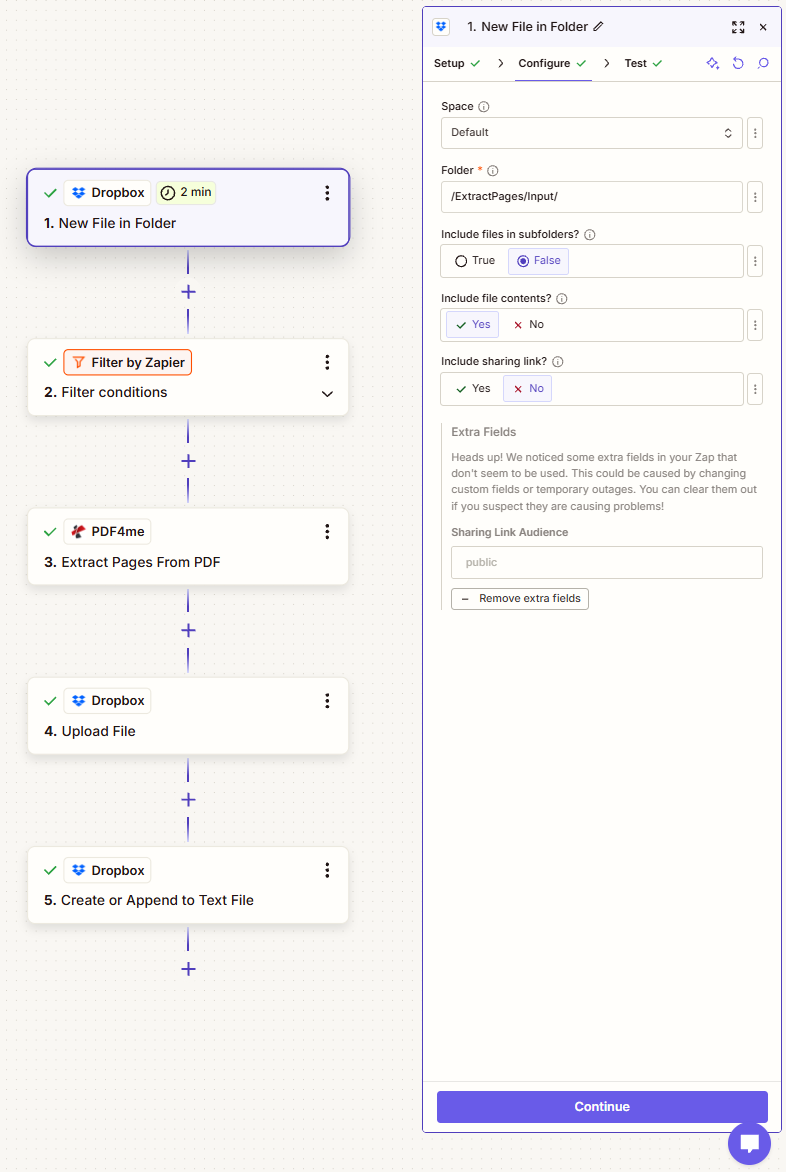
必须选择“包含文件内容”。否则,步骤 3 将获得一个没有字节的引用。
步骤 2:为什么要在调用 PDF4me 之前进行过滤?
目前为止的流程: 文件夹中新建文件。
过滤器并非操作,而是一道闸门。如果条件不成立,运行将静默停止,下游不会产生任何费用或错误。
- 添加 通过 Zapier 筛选 并开放 过滤条件。
- 放 仅当:
- 场地: 1. 文件扩展名 从触发器
- 健康)状况:
(Text) Contains - 价值:
pdf
过滤器条件配置
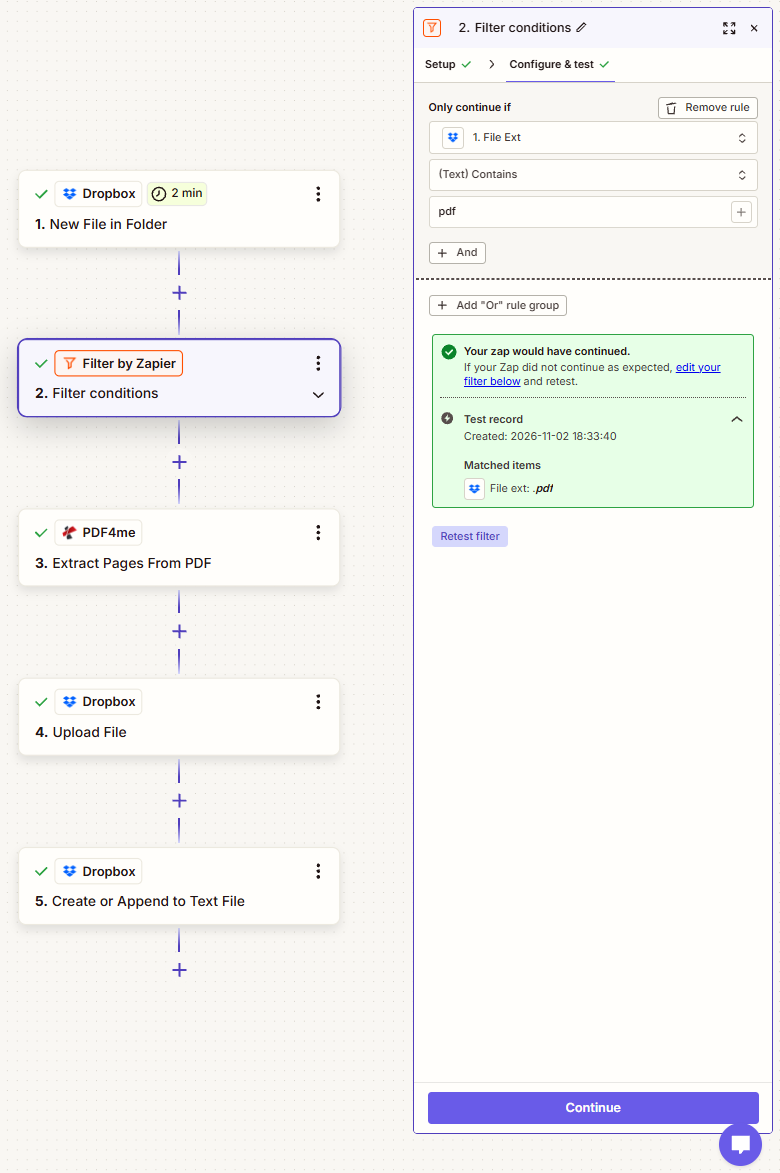
绿色面板确认测试记录将继续进行,匹配文件扩展名为 .pdf。编辑过滤器后务必重新测试。
提示。 “包含”的定义比较宽松,因此它同时包含 .pdf 和 .PDF 文件。 Zapier 的过滤器文档 如果您需要更严格的规则,例如设置大小下限以跳过零字节上传。
步骤 3:如何按页码从 PDF 中提取页面?
目前为止的流程: 在文件夹中新建文件并添加筛选条件。
这是真正起作用的步骤,其中只有一个字段至关重要。
- 添加 PDF4me 并选择 从PDF中提取页面 行动。
- 配置:
- 文件: 这 文件 步骤 1 的输出
- 文件 URL留空,则只能提供文件或文件 URL,不能同时提供两者。
- 文件名:
Quarterly-Report-Q3.pdf - 页码:
1-2
从 PDF 参数中提取页面
| 场地 | 所用价值 | 笔记 |
|---|---|---|
| 文件 | 步骤 1 中的文件 | 源 PDF 文件。请提供文件或文件 URL。 |
| 文件 URL | 空的 | 当 PDF 文件已有公开链接时,此方法可作为“文件”选项的替代方案。 |
| 文件名 | Quarterly-Report-Q3.pdf | 为操作指定输入。 |
| 页码 | 1-2 | 必需。需要保留的页面。 |
页码语法
| 你想 | 你输入 |
|---|---|
| 单页 | 3 |
| 多个独立页面 | 2,5,6 |
| 连续范围 | 4-7 |
| 两者的混合 | 1,3,5-10 |
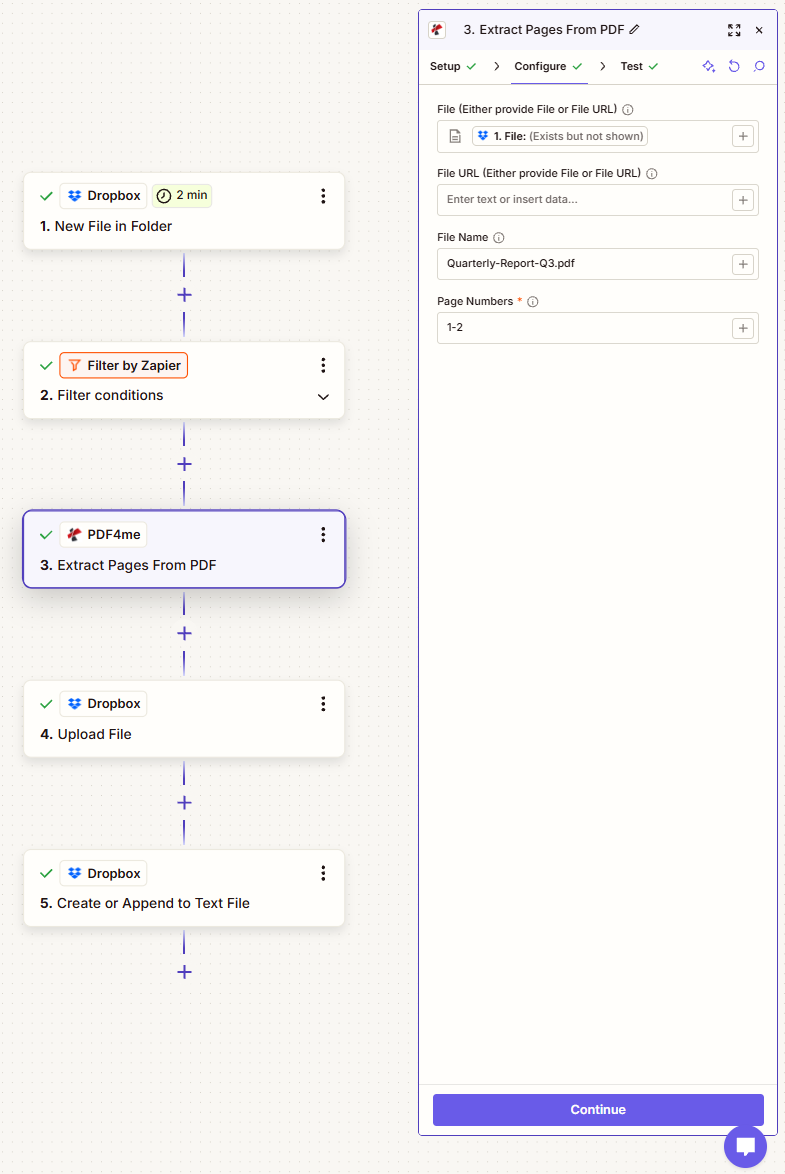
除了文件本身之外,页码是唯一必填字段。请从之前的步骤中映射该字段,以使页码范围能够根据每个文档动态变化。
提示。 页码从 1 开始,所以第一页是 1,而不是 0。请求超出文档末尾的页面会导致该步骤失败,而不是返回一个较短的 PDF 文件。
步骤 4:提取的 PDF 文件保存在哪里?
目前为止的流程: 在文件夹中新建文件 + 筛选条件 + 从 PDF 中提取页面。
- 添加 Dropbox 并选择 上传文件 行动。
- 配置:
- 空间:
Default - 文件夹:
/ExtractPages/Output - 文件: 这 文件 URL 步骤 3 的输出
- 覆盖:
True - 指定文件名:字面文本
Extracted-然后是 文件名 从步骤 1 开始 - 指定文件扩展名:
pdf - 包含分享链接吗?:
Yes
- 空间:
上传文件配置
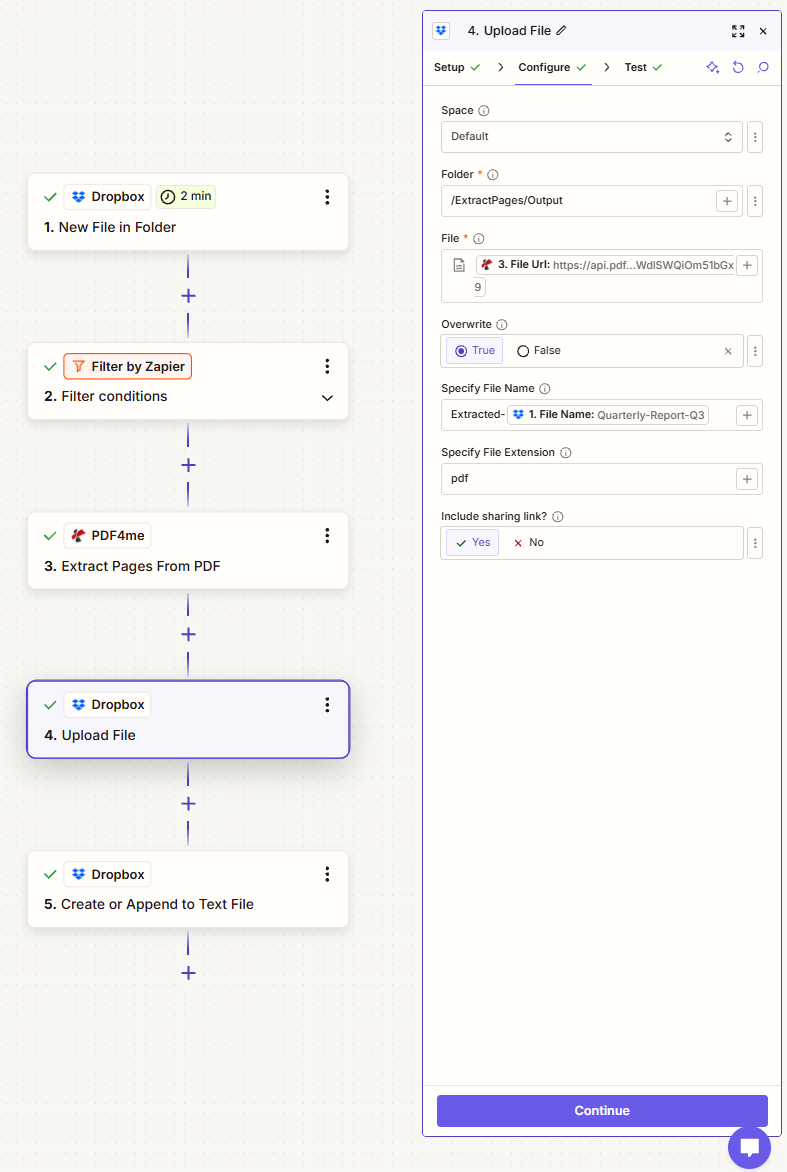
这里将“包含共享链接”设置为“是”,因为步骤 5 会将该链接添加到日志行中。
步骤 5:如何保留提取内容的审计跟踪?
目前为止的流程: 在文件夹中新建文件 + 筛选条件 + 从 PDF 中提取页面 + 上传文件。
- 添加 Dropbox 并选择 创建或追加到文本文件 行动。
- 配置:
- 空间:
Default - 文件夹:
/ExtractPages/Log - 文件名:
extract-pages-log.txt - 文件内容:字面文本
Processed | source:然后 文件名 从步骤 1 开始,然后| extracted pages 1-2 saved as:然后 分享链接 从步骤 4 开始 - 包含分享链接吗?:
Yes
- 空间:
创建或追加到文本文件配置
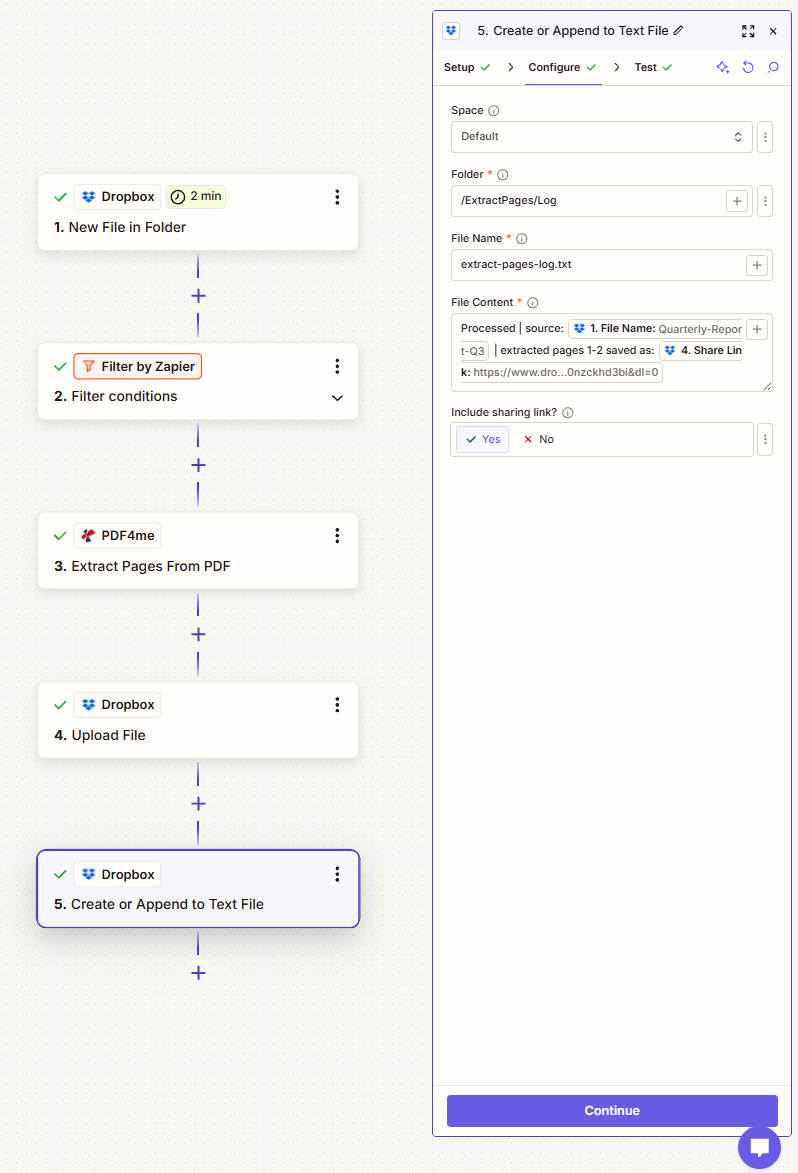
创建或追加意味着第一次运行会创建文件,之后每次运行都会添加一行,因此日志会不断增长而不是被覆盖。
运行流程并验证
- 发布 电击。
- 将多页 PDF 文件拖放到 /ExtractPages/Input/ 中,然后等待下一次轮询,最多两分钟。
- 打开 Zap 运行 并确认所有五个步骤都显示绿色勾号,且筛选器报告显示筛选过程继续进行。
- 打开 /ExtractPages/Output 并检查新生成的 PDF 是否只包含您要求的页面,然后打开 extract-pages-log.txt 并确认新增的行。
你实际建造了什么? 一个带门控和日志记录的文档处理流程。门控机制阻止错误输入,每个操作只执行一项任务,而日志记录则使整个过程事后可审计。替换中间的操作,同样的五步流程即可实现压缩、转换、添加水印或OCR识别。
无需重建即可添加的常见变体
自动化提取器与手动提取器
| Zap 与手动 | 这个 Zap | 在线提取器 |
|---|---|---|
| 扳机 | 文件落入文件夹 | 开办网站的人 |
| 页面范围 | 输入一次,或按文档映射 | 每次都重新选择 |
| 文件命名 | 这 Extracted- 前缀加上源名称 | 无论浏览器下载什么 |
| 审计跟踪 | 带有共享链接的永久日志条目 | 没有任何 |
| 输入错误 | 被过滤器挡住了 | 上传后发现 |
常见问题
如何从PDF文件中提取页面?
你只需命名所需的页面,该工具就会将它们复制到一个新文档中,而不会触及原始文档。在本示例中,PDF4me 的“从 PDF 中提取页面”操作会从 Dropbox 获取源文件,并…… 页码 价值 1-2并返回一个只包含这两页的新 PDF 文件。
如何免费从PDF文件中提取页面?
对于单个文档,免费选项随处可见,包括大多数浏览器自带的打印对话框(如果您选择打印为 PDF 并设置页面范围)。自动化版本则并非免费:它需要付费的 Zapier 套餐,因为这涉及五个步骤的 Zap,外加 PDF4me API 调用。真正的分水岭在于文档数量。如果每月文档数量少于几份,手动打印即可。
如何从PDF文件中提取页面并创建一个新的PDF文件?
这正是此操作的作用。“从 PDF 中提取页面”操作绝不会修改源文件。它会返回一个全新的 PDF 文件,然后步骤 4 会将其写入另一个文件夹并重命名,这样您最终就能同时拥有原始文件和提取后的文件。
如何在不使用 Adobe 的情况下从 PDF 文件中提取页面?
此工作流程中无需使用任何 Adobe 软件。PDF4me 通过其 API 处理文件,Zapier 进行协调,最终存储在 Dropbox 中。唯一涉及的桌面软件是您用来打开最终 PDF 文件的软件。
我可以按页码从PDF文件中提取页面吗?
是的,只有通过页码才能选择页面。请输入单个页面作为 3分开页面 2,5,6,一个连续的范围 4-7或者两者兼而有之 1,3,5-10编号从1开始。
故障排除
您请求的页码在文档中并不存在。一个十页的 PDF 文件不可能返回 1-12 页。如果页码范围因文件而异,请根据数据进行映射,而不是硬编码,并将上限值保持在您预期的最短文档范围内。
请先检查筛选条件。如果文件扩展名不包含 pdf,则运行会故意在第二步停止,并显示为“未继续”,而不是错误。
您使用的是“上传文件”操作,而不是“创建”或“追加到文本文件”操作。只有追加操作才能将内容添加到现有文件中,并且每次运行文件名都必须完全一致。
输出或日志文件夹位于被监控的文件夹内。请将 /ExtractPages/Output 和 /ExtractPages/Log 放在 /ExtractPages/Input/ 之外,就像本版本中那样。
后续步骤
同样的五步模式(观察、关闭、执行、保存、记录)可以处理任何“收到文档,对其执行一件事”的自动化操作。