Taranmış belgelerin veya görüntülerin metin arama özelliğine sahip PDF dosyalarına dönüştürülmesi, bu belgelerin daha sonraki işlemleri için önemlidir. PDF'leri aranabilir hale getirmek için kullanılan teknoloji optik karakter tanıma (OCR) teknolojisidir. İşletmeler ve kurumlar için işlenmesi gereken çok sayıda belge olabilir. Bu da PDF OCR otomasyonunu gerektirir.
PDF4me, en doğru metin tanıma sonuçlarından birini üreten yüksek kaliteli PDF OCR hizmeti sunar. Ancak yüzlerce taranmış belgeyi tanımanız gerektiğinde tek çözüm otomasyondur. PDF4me İş Akışları, bu otomasyonu gerçekleştirmek için doğru eyleme sahiptir: PDF OCR .
İş akışlarını kullanarak PDF OCR işlemini nasıl otomatikleştirebilirsiniz?
Taranmış belgelerden veya resimlerden metin içeren aranabilir PDF dosyaları oluşturun. Bu işlem, oluşturulan PDF dosyasından metin aramanıza veya kopyalamanıza olanak tanır.
PDF OCR işlemi içeren örnek bir iş akışına bakalım. Öncelikle İş Akışları Panosundan İş Akışı Oluştur'u seçin.

İş akışına bir tetikleyici ekleyin.
İş akışı otomasyonunu başlatmak için bir tetikleyici oluşturun ve yapılandırın. Tetikleyicide yapılandırılmış klasöre yeni bir dosya gelir gelmez otomasyon başlatılır.
Örnek olarak Google Drive tetikleyicisini kullanalım.

PDF OCR işlemini ekleyin
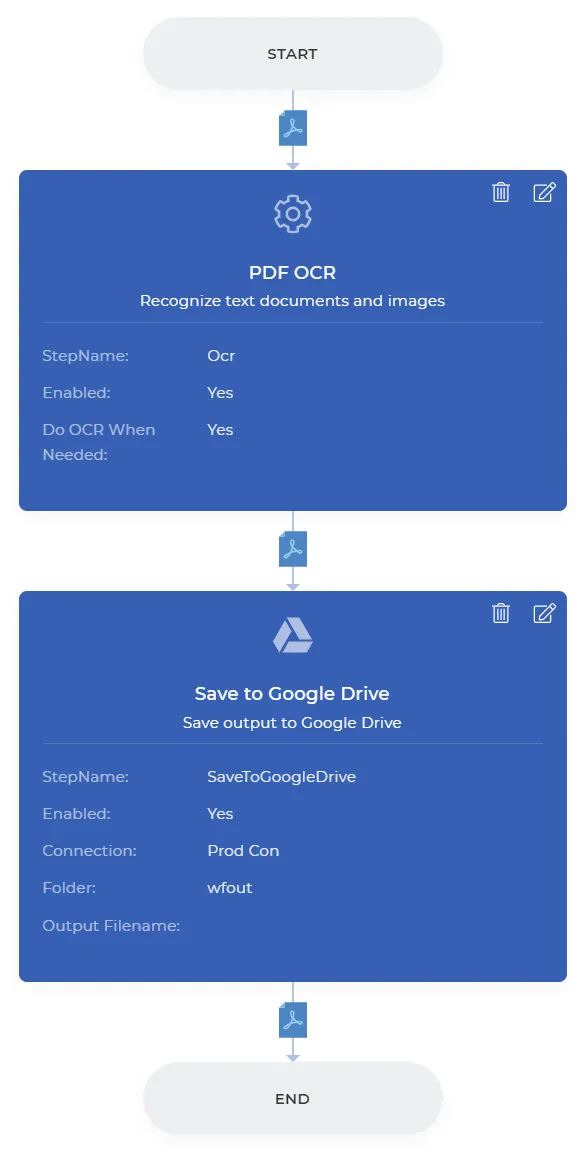
Gereksiz çağrıları önlemek ve OCR'nin yalnızca gerektiğinde kullanılmasını sağlamak için ODF OCR eylemini ekleyin ve "Gerektiğinde OCR Yap" seçeneğini etkinleştirin.

Kaydet'i depoya ekle
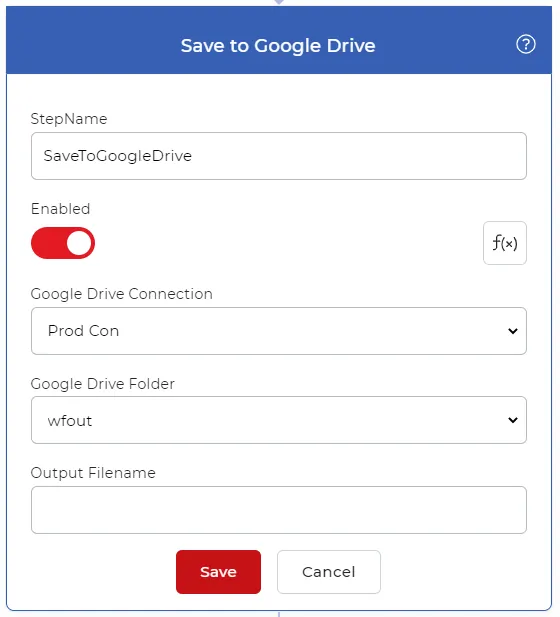
Çıktı dosyalarını kaydetme işlemini ekleyin. Örnek olarak "Google Drive'a Kaydet" seçeneğini seçebiliriz. İşlenmiş dosyalarınızın kaydedilmesini istediğiniz klasörü yapılandırın.
Yapılandırmalar tamamlandıktan sonra, İş Akışını Yayınlamak için Kaydet'e tıklayabilirsiniz. Örnek bir İş Akışı aşağıdaki gibi görünecektir.