私たちは、膨大な量の文書の中から、ごく一部の情報だけを必要とする場面によく遭遇します。契約書、法律文書、電子書籍などのPDF文書は、数百ページ、あるいは数千ページにも及ぶことがあります。場合によっては、これらの文書の中から数ページだけが必要になることもあります。そのような場合、特定のツールを使ってPDFから該当ページを抽出する必要があります。しかし、ほとんどのソフトウェアサービスで同様の機能が備わっています。
これで、PDF ドキュメントから特定のページを自動的に抽出できるようになりました。 抽出ページ PDF4meからのアクションアクションを使用する PDF4me Connect 統合 パワーオートマ このプロセスを自動化するためのフローを作成します。簡単な設定とコーディング不要で、PDFページを抽出するフローを簡単にセットアップできます。
PDFからページを自動的に抽出する方法は?
この機能を使用すると、ドキュメントのページを分離してさらに処理することができます。PDFページの抽出を自動化するフローの構築方法を、サンプルフローで見ていきましょう。
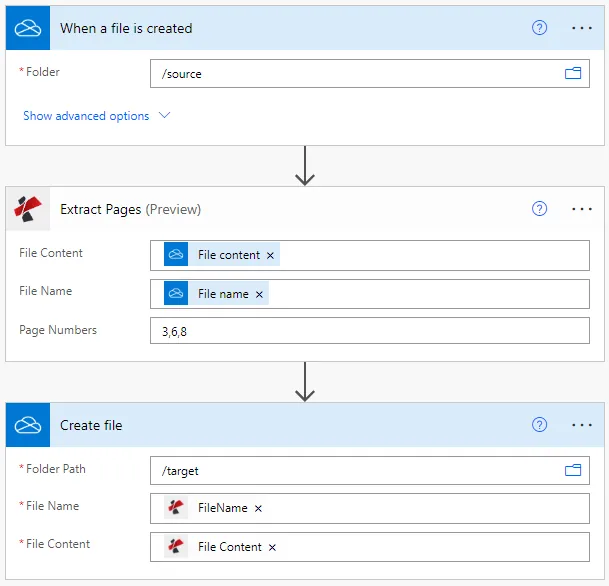
フローにトリガーを追加する
PDF4meの抽出アクションに、入力されたPDFドキュメントを渡すトリガーを任意に追加できます。ここでは、OneDriveトリガーを追加して設定してみましょう。PDFファイルが保存されるフォルダをマッピングしてください。

PDFからページを抽出するアクションを追加する
PDF4me Connectアクションを追加して構成します PDFからページを抽出するソースPDFから抽出したいページのページ番号を指定してください。

出力を保存するアクションを追加します
OneDriveストレージから始めたので、OneDriveを追加しましょう。 ファイルを作成する ソースファイルから抽出したページを使用して作成されたPDFを保存する操作。
