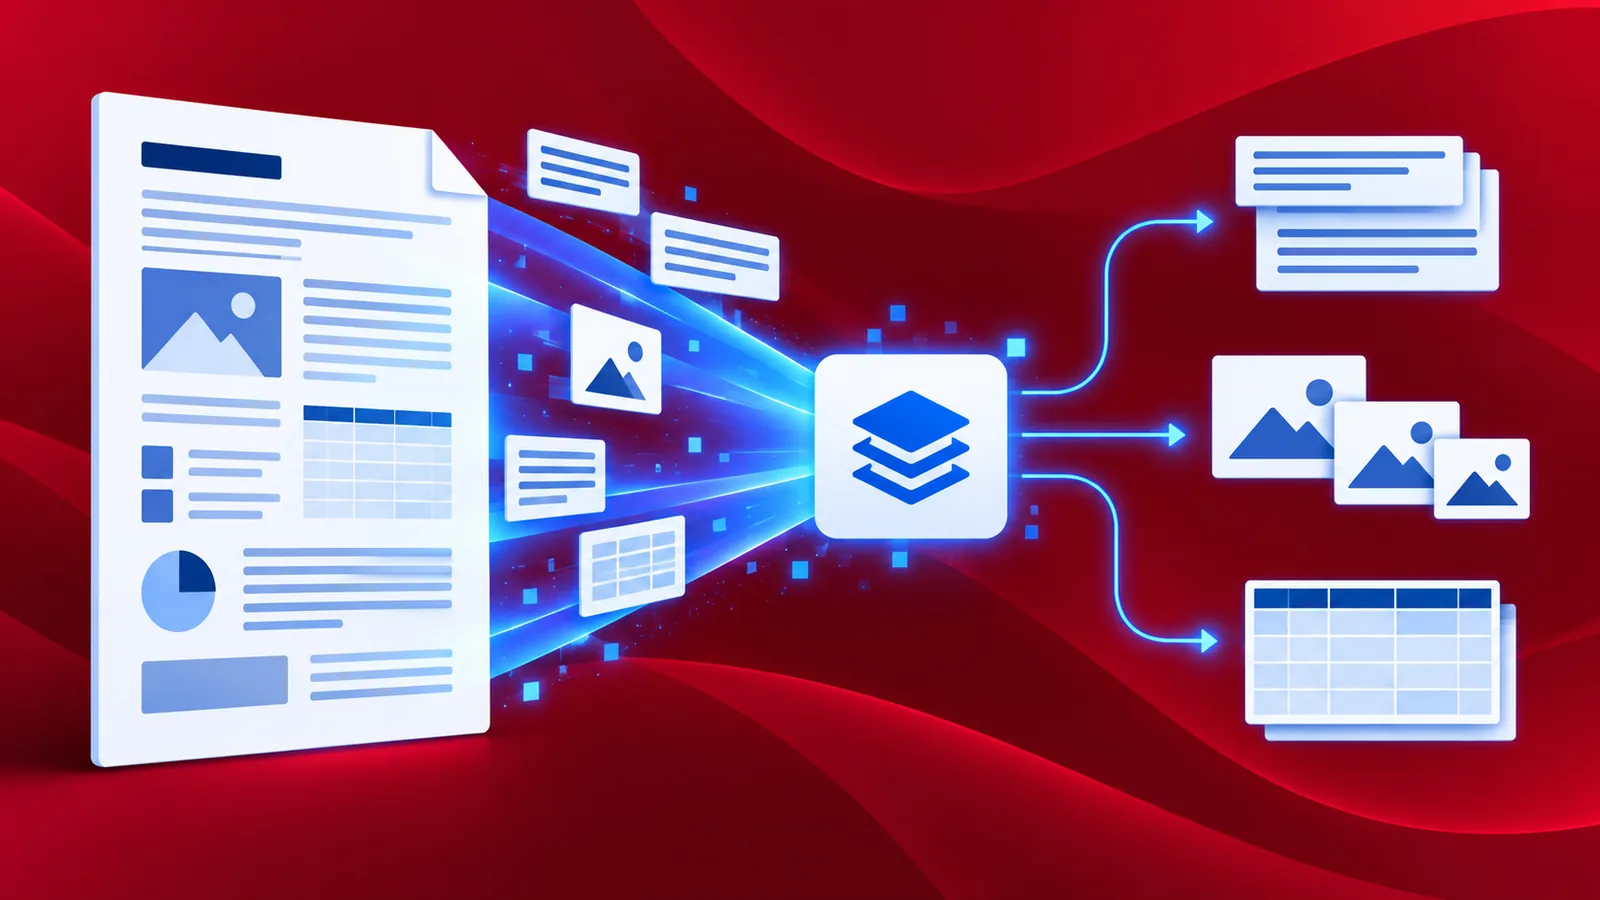
すべての文書は、1つ以上の構成要素から成り立っています。多くの場合、文書にはテキストと画像のみが含まれています。これは、私たちが扱うほとんどすべての文書に当てはまります。マクロや動画、その他の特殊な構成要素が含まれていることは稀です。これは、私たちが扱うPDFファイルにも同様に当てはまります。場合によっては、これらのPDFファイル内の画像とテキストコンテンツを個別に利用したいことがあります。
さて、PDF4meにはこの状況を解決するのに役立つ適切なツールがあります。 リソースを抽出する 道具 PDF4meオンラインツールスイートを使えば、あらゆるPDFファイルからテキストと画像を簡単に分離できます。画像やテキストを抽出したいファイルをドラッグ&ドロップするだけで、抽出されたコンポーネントがZipファイルとして出力されます。
PDFファイルから画像とテキストをオンラインで抽出する方法は?
当社のリソース抽出ツールを使用すると、PDFに含まれるすべての画像とテキストをページごとに簡単に抽出できます。まず、ツールを起動してみましょう。 PDF4meオンラインツールページ。
- コンテンツを抽出したいPDFファイルをアップロードするか、ドラッグ&ドロップしてください。
- 要件に基づいて、抽出に適したプロファイルを選択してください。
- テキストと画像 PDFファイルからすべてのテキストと画像を抽出します。
- テキストのみ PDFファイルからテキストコンテンツのみを抽出します。
- 画像のみ PDF文書に含まれる画像のみを抽出します。
- プロフィールを選択したら、クリックしてください。 抽出を開始します処理が完了すると、PDFファイル内のリソースがZipファイルとしてダウンロードできるようになります。