Extraire des pages d'un PDF Cette action PDF4me pour Zapier permet de copier une plage de pages d'un PDF dans un nouveau fichier. Ce Zap en cinq étapes surveille un dossier Dropbox, filtre les PDF, extrait les pages spécifiées, enregistre le résultat sous un nom de fichier identifiable et ajoute une ligne à un fichier journal.
Extraire trois pages d'un rapport de soixante pages prend dix secondes. Le faire pour chaque rapport reçu, indéfiniment, est une autre paire de manches. Les extracteurs en ligne qui apparaissent dans les résultats de recherche partent tous du principe qu'un utilisateur sélectionne manuellement les numéros de page. Ce tutoriel présente la version autonome, avec des captures d'écran et les valeurs exactes des champs d'un Zap exécuté le 2 novembre 2026.
Déposez un PDF dans un dossier Dropbox surveillé. Un filtre élimine tout fichier qui n'est pas un PDF, PDF4me extrait les pages 1 et 2 dans un nouveau document, Dropbox l'enregistre sous le nom Rapport-trimestriel-Extrait-T3.pdf, et un fichier journal est mis à jour avec une ligne indiquant la source, la plage de pages et un lien de partage. Cinq étapes seulement, sans sélection manuelle des pages.
Questions et réponses basées sur le pourquoi
Pourquoi ajouter un filtre alors que le dossier ne contient que des fichiers PDF ? Les dossiers restent rarement parfaitement rangés. Un fichier .docx égaré, un fichier .DS_Store ou un fichier partiellement téléchargé risquerait d'atteindre PDF4me et d'interrompre le traitement. Le filtre est gratuit et transforme une erreur signalée en un arrêt propre et intentionnel.
Pourquoi le dossier de sortie est-il différent du dossier d'entrée ? Le déclencheur surveille le dossier /ExtractPages/Input/. Si le PDF extrait est réenregistré dans ce même dossier, Dropbox signale un nouveau fichier et le Zap se déclenche sur sa propre sortie, puis à nouveau, et ainsi de suite.
Pourquoi enregistrer les données dans un fichier texte ? L'historique d'exécution des Zaps dans Zapier expire. Une ligne ajoutée au fichier extract-pages-log.txt est permanente, stockée à côté des documents et accessible à toute personne ayant accès à Dropbox, et non plus seulement au propriétaire du Zap.
Pourquoi nommer le fichier de sortie à partir du fichier source ? Le fichier Extracted-Quarterly-Report-Q3.pdf indique sa provenance. Un nom générique, en revanche, ne le fait pas, et lorsqu'il y en a plusieurs centaines dans un dossier, la différence entre un nom identifiable et un nom opaque se joue en heures.
Ce que vous obtiendrez
Saisir: tout fichier PDF déposé dans /ExtractPages/Input/. Sortir: Un nouveau PDF dans /ExtractPages/Output contenant uniquement les pages que vous avez nommées, plus une ligne d'audit dans /ExtractPages/Log/extract-pages-log.txt.
Ce dont vous avez besoin
- Zapier. Ouvrez l'application PDF4me ZapierIl s'agit d'un Zap en cinq étapes, il nécessite donc un abonnement Zapier payant.
- Clé API PDF4me. Obtenez votre clé APIConnectez-le la première fois que vous ajoutez une action PDF4me.
- Dropbox avec trois dossiers : /ExtractPages/Input/, /ExtractPages/Output et /ExtractPages/Log.
- Un PDF de plusieurs pages à tester avecL'exemple ci-dessous est celui utilisé dans ces captures d'écran.
Commencez par prendre les échantillons. Déposez le fichier dans /ExtractPages/Input/ une fois le Zap publié, et comparez le résultat dans /ExtractPages/Output avec le résultat attendu.
Aperçu du flux
- Nouveau fichier dans le dossier (Déclencheur Dropbox, interrogation toutes les 2 minutes).
- Conditions de filtrage (Filtre par Zapier) continue uniquement pour les PDF.
- Extraire des pages d'un PDF (PDF4me) avec la plage de pages.
- Téléverser un fichier (Dropbox) enregistre l'extrait.
- Créer ou ajouter des données à un fichier texte (Dropbox) écrit la ligne d'audit.
Aperçu complet du flux
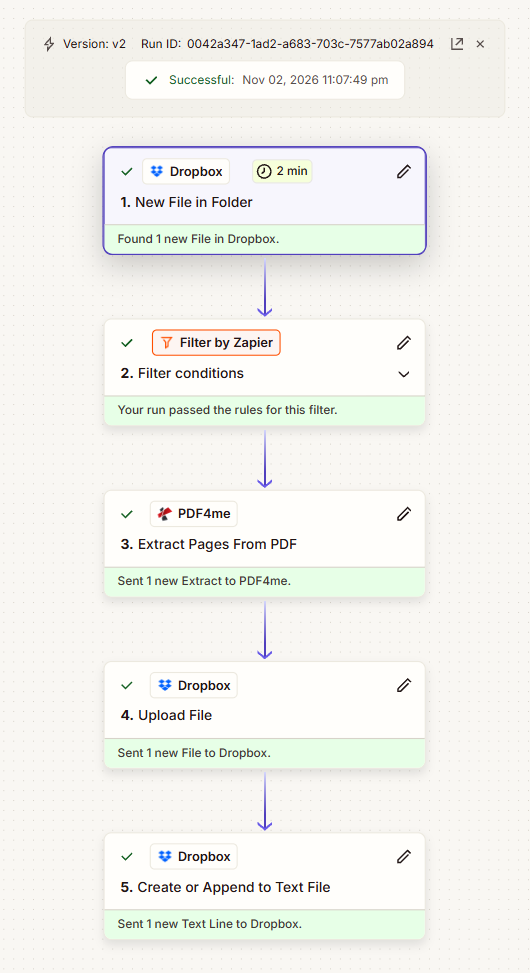
Exécution réussie le 2 novembre 2026. Le filtre est positionné en deuxième position, donc rien n'atteint PDF4me à moins qu'il ne s'agisse d'un fichier PDF.
Étape 1 : Comment surveiller un dossier Dropbox pour détecter les nouveaux fichiers PDF ?
Flux jusqu'à présent : Rien pour l'instant, voici le déclencheur.
- Ajouter Dropbox comme application de déclenchement et choisissez le Nouveau fichier dans le dossier événement.
- Configure:
- Espace:
Default - Dossier:
/ExtractPages/Input/ - Inclure les fichiers des sous-dossiers ?:
False - Inclure le contenu du fichier ?:
Yes - Inclure le lien de partage ?:
No
- Espace:
Configuration du nouveau fichier dans le dossier
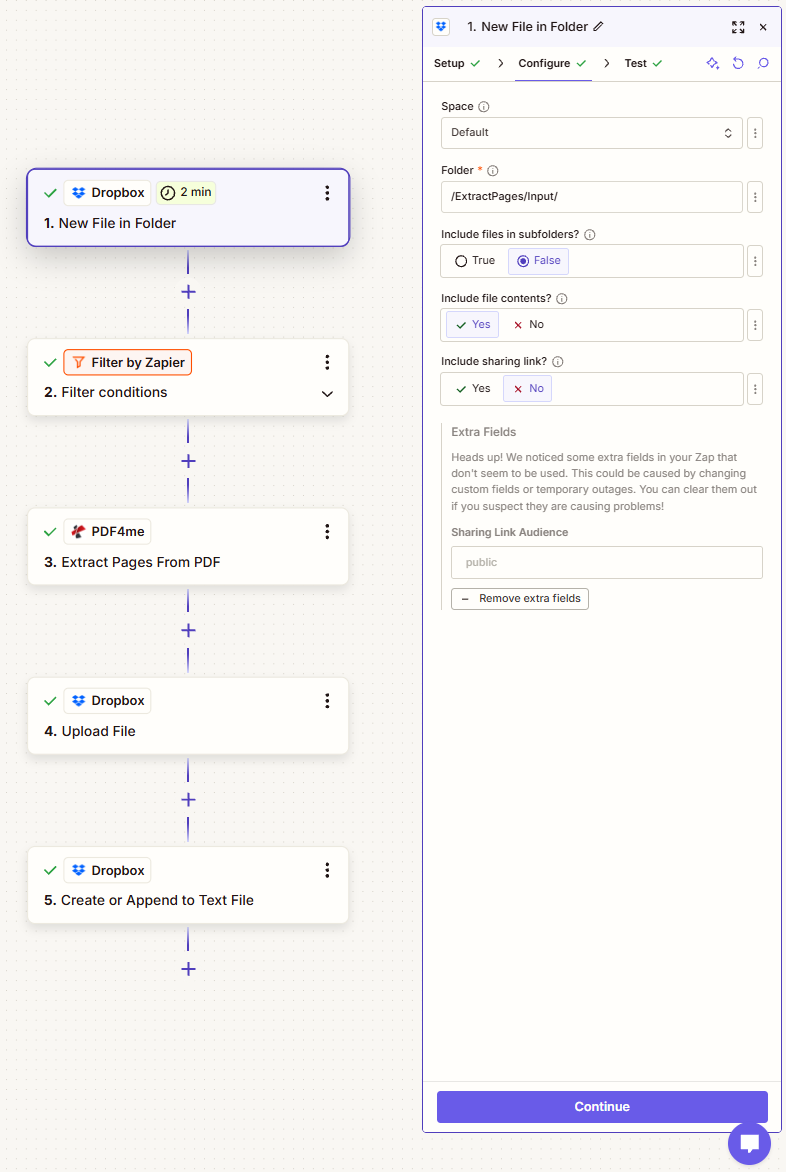
L'option « Inclure le contenu du fichier » doit être activée. Sans cela, l'étape 3 recevra une référence sans données.
Étape 2 : Pourquoi filtrer avant d’appeler PDF4me ?
Flux jusqu'à présent : Nouveau fichier dans le dossier.
Un filtre n'est pas une action, c'est une porte. Si la condition n'est pas remplie, l'exécution s'arrête automatiquement et aucune charge ni erreur n'est signalée en aval.
- Ajouter Filtrer par Zapier et ouvert Conditions de filtrage.
- Ensemble Continuez seulement si:
- Champ: 1. Extension de fichier à partir du déclencheur
- Condition:
(Text) Contains - Valeur:
pdf
configuration des conditions de filtrage
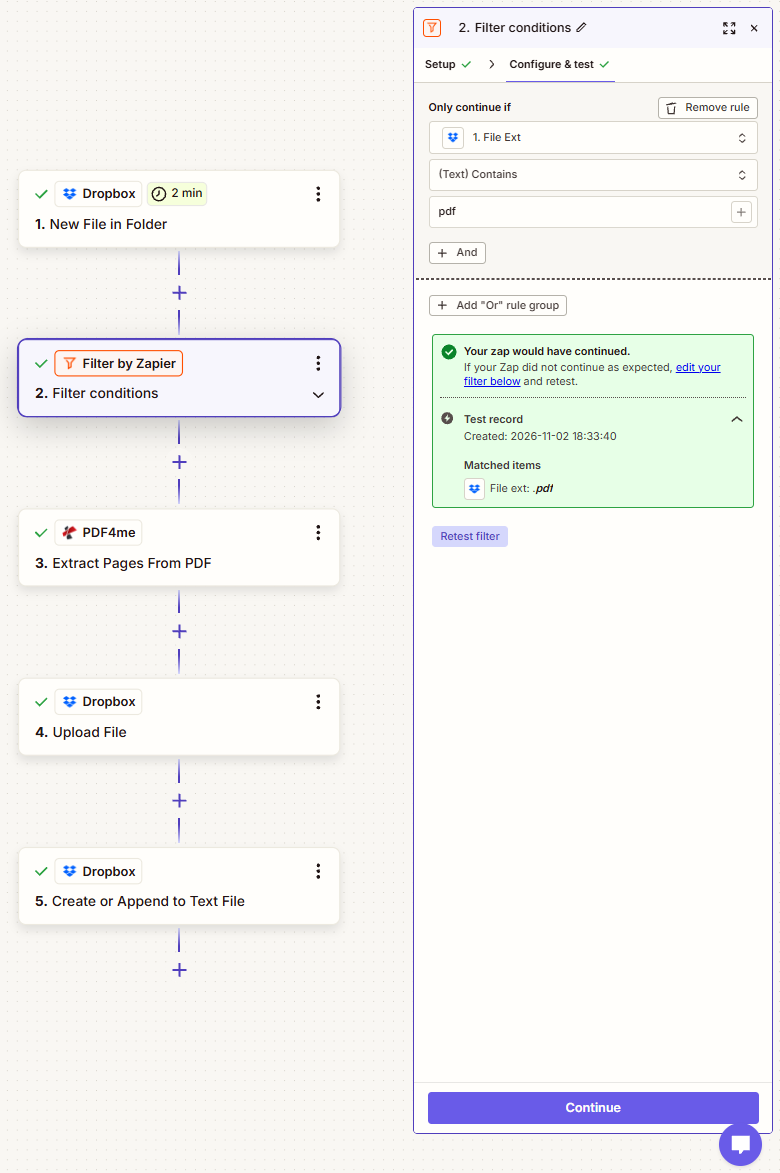
Le panneau vert confirme que l'enregistrement de test se serait poursuivi, correspondant à l'extension de fichier .pdf. Il est toujours recommandé de tester à nouveau le filtre après l'avoir modifié.
Conseil. Le terme « Contains » est volontairement imprécis, afin de correspondre indifféremment aux formats .pdf et .PDF. Utilisez-le. Documentation des filtres de Zapier si vous avez besoin de règles plus strictes, par exemple une taille minimale pour ignorer les téléchargements de zéro octet.
Étape 3 : Comment extraire des pages d'un PDF par numéro de page ?
Flux jusqu'à présent : Nouveau fichier dans le dossier, plus conditions de filtrage.
C'est cette étape qui fait le travail, et elle ne comporte qu'un seul champ qui compte vraiment.
- Ajouter PDF4me et choisissez le Extraire des pages d'un PDF action.
- Configure:
- Déposer: le Déposer résultat de l'étape 1
- URL du fichierLaissez ce champ vide. Vous devez indiquer soit le fichier, soit son URL, jamais les deux.
- Nom de fichier:
Quarterly-Report-Q3.pdf - Numéros de page:
1-2
Paramètres d'extraction de pages à partir d'un PDF
| Champ | Valeur utilisée | Notes |
|---|---|---|
| Déposer | Fichier de l'étape 1 | Le fichier PDF source. Veuillez indiquer soit le fichier lui-même, soit son URL. |
| URL du fichier | vide | Alternative à l'option « Fichier » lorsque le PDF possède déjà un lien public. |
| Nom de fichier | Quarterly-Report-Q3.pdf | Indique l'entrée de l'action. |
| Numéros de page | 1-2 | Obligatoire. Les pages à conserver. |
Syntaxe des numéros de page
| Tu veux | Vous tapez |
|---|---|
| Une seule page | 3 |
| Plusieurs pages distinctes | 2,5,6 |
| Une gamme continue | 4-7 |
| Un mélange des deux | 1,3,5-10 |
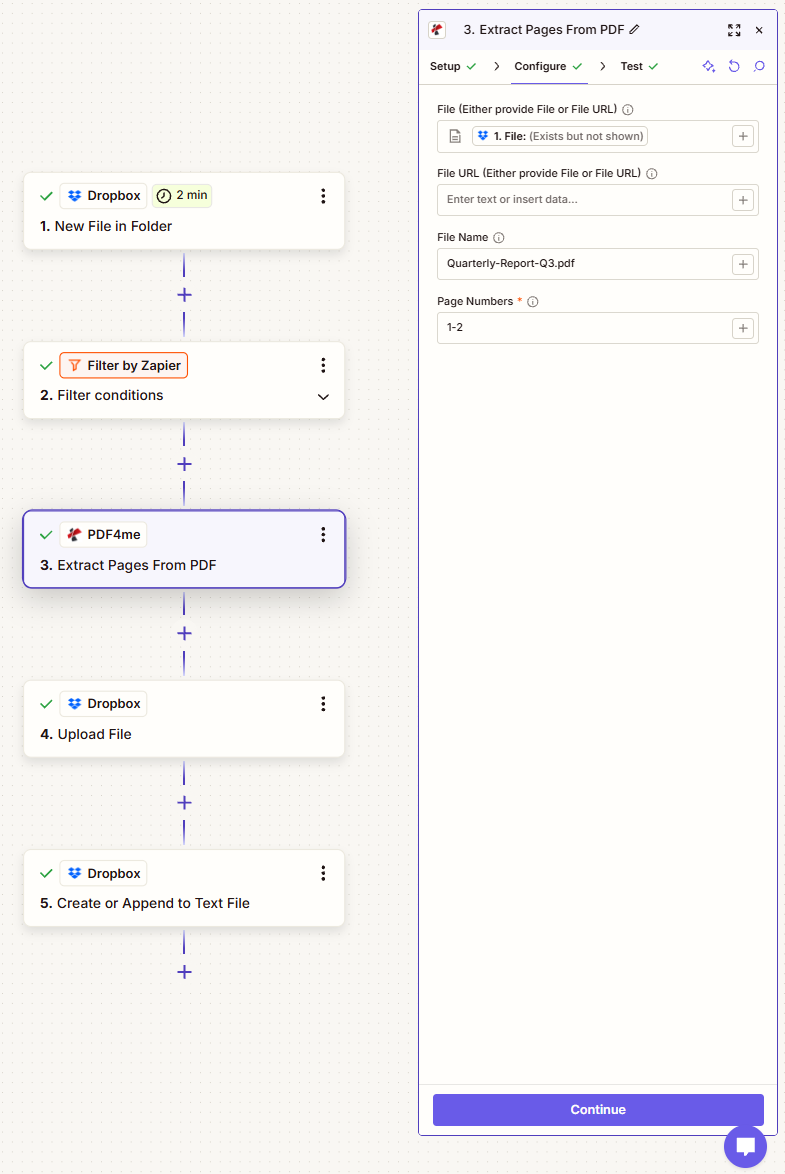
Le champ « Numéros de page » est le seul champ obligatoire en plus du nom du fichier. Il est nécessaire de le mapper à partir d'une étape précédente afin que la plage de numéros soit dynamique pour chaque document.
Conseil. La numérotation des pages commence à 1, donc la première page est la page 1 et non la page 0. Demander une page au-delà de la fin du document entraîne l'échec de l'étape au lieu de renvoyer un PDF plus court.
Étape 4 : Où est stocké le fichier PDF extrait ?
Flux jusqu'à présent : Nouveau fichier dans le dossier + Conditions de filtrage + Extraire les pages du PDF.
- Ajouter Dropbox et choisissez le Téléverser un fichier action.
- Configure:
- Espace:
Default - Dossier:
/ExtractPages/Output - Déposer: le URL du fichier résultat de l'étape 3
- Écraser:
True - Spécifiez le nom du fichier: le texte littéral
Extracted-suivi par le Nom de fichier à partir de l'étape 1 - Spécifiez l'extension du fichier:
pdf - Inclure le lien de partage ?:
Yes
- Espace:
Configuration du téléchargement de fichiers
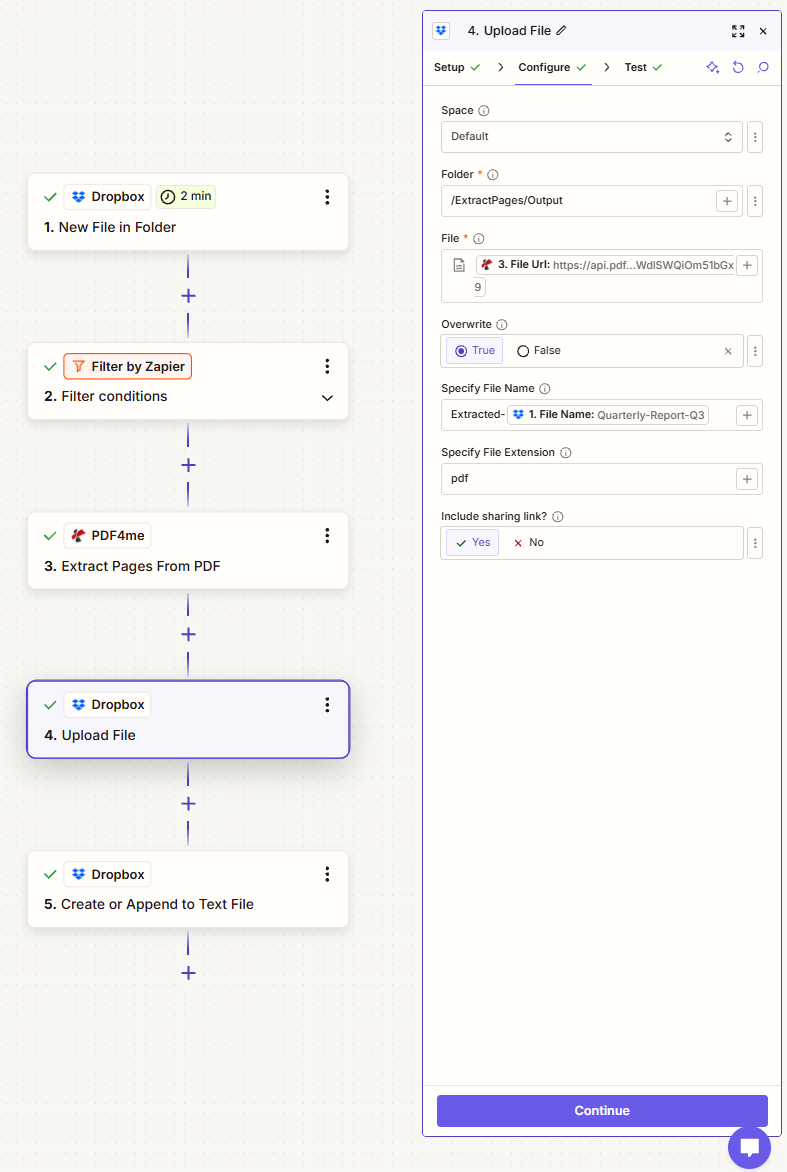
L'option « Inclure le lien de partage » est définie sur « Oui » ici car l'étape 5 insère ce lien dans la ligne de journal.
Étape 5 : Comment conservez-vous une trace écrite des éléments extraits ?
Flux jusqu'à présent : Nouveau fichier dans le dossier + Conditions de filtrage + Extraire les pages du PDF + Téléverser un fichier.
- Ajouter Dropbox et choisissez le Créer ou ajouter des données à un fichier texte action.
- Configure:
- Espace:
Default - Dossier:
/ExtractPages/Log - Nom de fichier:
extract-pages-log.txt - Contenu du fichier: le texte littéral
Processed | source:puis le Nom de fichier à partir de l'étape 1, puis| extracted pages 1-2 saved as:puis le Partager le lien à partir de l'étape 4 - Inclure le lien de partage ?:
Yes
- Espace:
Créer ou ajouter à la configuration du fichier texte
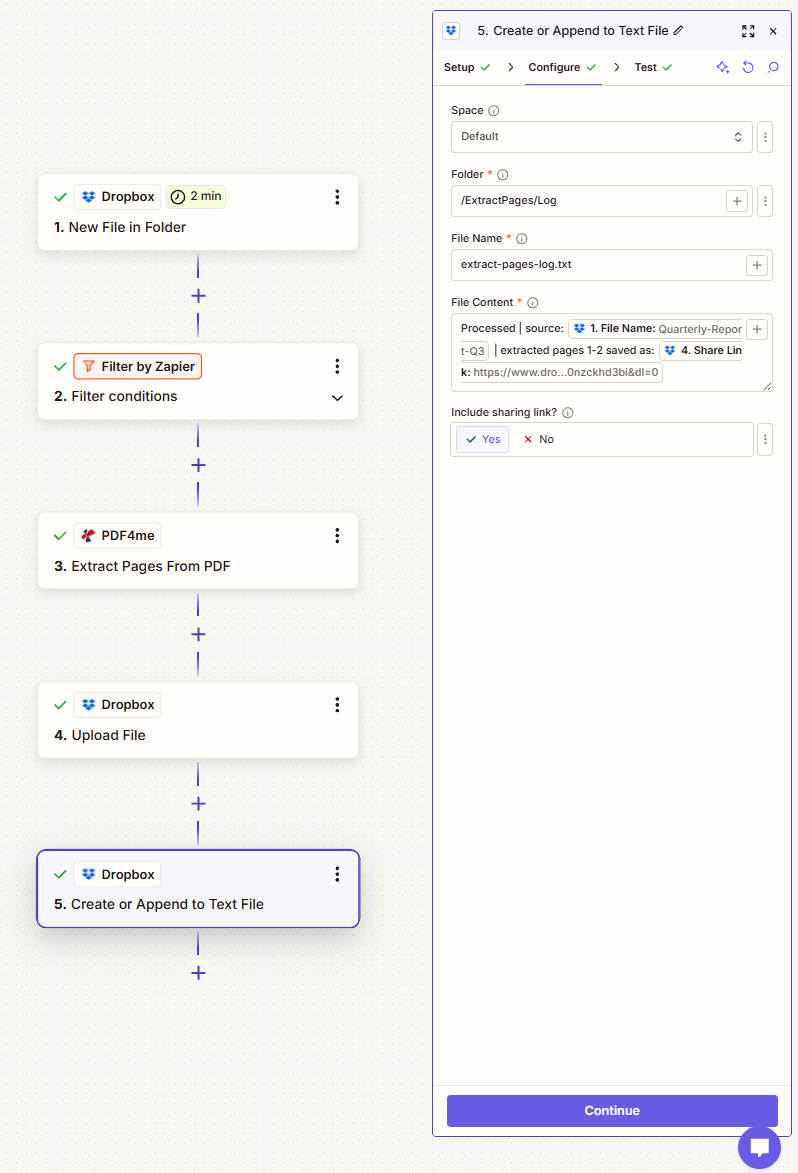
L'option « Créer ou Ajouter » signifie que la première exécution crée le fichier et que chaque exécution suivante ajoute une ligne, de sorte que le journal s'agrandit au lieu d'être écrasé.
Exécutez le flux et vérifiez
- Publier le Zap.
- Déposez un fichier PDF de plusieurs pages dans /ExtractPages/Input/ et attendez le prochain sondage, jusqu'à deux minutes.
- Ouvrir Zap fonctionne et vérifiez que les cinq étapes affichent une coche verte, le filtre indiquant qu'il s'est poursuivi.
- Ouvrez /ExtractPages/Output et vérifiez que le nouveau PDF ne contient que les pages demandées, puis ouvrez extract-pages-log.txt et confirmez la nouvelle ligne.
Qu'avez-vous construit concrètement ? Un processus de traitement de documents contrôlé et journalisé. Le contrôle empêche les données erronées d'entrer, l'action effectue une tâche précise et le journal permet de retracer l'ensemble du processus a posteriori. En modifiant l'action intermédiaire, le même schéma en cinq étapes prend en charge la compression, la conversion, l'ajout de filigrane ou la reconnaissance optique de caractères (OCR).
Variantes courantes que vous pouvez ajouter sans reconstruction
Extraction automatisée versus extraction manuelle
| Zap vs manuel | Ce Zap | Un extracteur en ligne |
|---|---|---|
| Déclenchement | Un fichier atterrissant dans un dossier | Une personne ouvrant un site |
| Plage de pages | Saisie une seule fois ou mappée par document | Choisi à chaque fois |
| Nommer les fichiers | Le Extracted- préfixe plus le nom de la source | Quoi que le navigateur télécharge |
| Piste d'audit | Une ligne de journal permanente avec un lien de partage | Aucun |
| Mauvaise entrée | Arrêté par le filtre | Découvert après la mise en ligne |
Questions fréquentes
Comment extraire des pages d'un PDF ?
Vous nommez les pages souhaitées et l'outil les copie dans un nouveau document, laissant l'original intact. Dans ce Zap, l'action « Extraire des pages d'un PDF » de PDF4me utilise le fichier source depuis Dropbox et un Numéros de page valeur de 1-2et renvoie un nouveau PDF contenant uniquement ces deux pages.
Comment extraire gratuitement des pages d'un PDF ?
Pour un seul document, les options gratuites sont légion, notamment la boîte de dialogue d'impression intégrée à la plupart des navigateurs si vous imprimez au format PDF et définissez une plage de pages. La version automatisée est payante : elle nécessite un abonnement Zapier, car il s'agit d'un Zap en cinq étapes, plus des appels à l'API PDF4me. Le critère déterminant est le volume. En dessous de quelques documents par mois, il est préférable de procéder manuellement.
Comment extraire des pages d'un PDF et créer un nouveau PDF ?
C'est précisément le rôle de cette action. Extraire les pages d'un PDF ne modifie jamais le fichier source. Elle génère un nouveau PDF, que l'étape 4 enregistre ensuite dans un dossier différent sous un nouveau nom. Vous obtenez ainsi à la fin le fichier original et l'extrait.
Comment extraire des pages d'un PDF sans Adobe ?
Aucun logiciel Adobe n'est utilisé dans ce processus. PDF4me traite le fichier via son API, Zapier orchestre le tout et Dropbox assure le stockage. Le seul logiciel requis est celui que vous utilisez pour ouvrir le PDF final.
Est-il possible d'extraire des pages d'un PDF par numéro de page ?
Oui, et les numéros de page sont le seul moyen pour cette action de sélectionner des pages. Saisissez une seule page comme 3, pages séparées comme 2,5,6, une gamme continue comme 4-7, ou un mélange comme 1,3,5-10La numérotation commence à 1.
Dépannage
Vous avez demandé une page qui n'existe pas dans le document. Un PDF de dix pages ne peut pas renvoyer les numéros de page de 1 à 12. Si la plage de numéros varie d'un fichier à l'autre, utilisez des données plutôt que de la coder en dur, et veillez à ce que la limite supérieure ne dépasse pas la taille du document le plus court que vous prévoyez.
Vérifiez d'abord le filtre. Si l'extension du fichier ne contenait pas de PDF, l'exécution s'est arrêtée intentionnellement à l'étape 2 et affichera « n'a pas continué » plutôt qu'une erreur.
Vous utilisez l'option « Téléverser un fichier » au lieu de « Créer » ou « Ajouter à un fichier texte ». Seule l'action « Ajouter » permet d'ajouter des données à un fichier existant, et le nom du fichier doit être identique à chaque exécution.
Le dossier de sortie ou de journalisation se trouve dans le dossier surveillé. Conservez les dossiers /ExtractPages/Output et /ExtractPages/Log en dehors du dossier /ExtractPages/Input/, comme dans cette configuration.
Prochaines étapes
Le même schéma en cinq étapes (observer, contrôler, agir, enregistrer, consigner) gère toute automatisation de type « un document est arrivé, effectuez une action sur celui-ci ».